- El web scraping permite transformar información desordenada de internet en bases de datos estructuradas y útiles.
- Existen múltiples enfoques para la extracción, desde fórmulas sencillas en hojas de cálculo hasta sistemas avanzados basados en inteligencia artificial.
- La elección de la herramienta depende del volumen de datos, la complejidad técnica del sitio y la necesidad de automatización constante.
- El cumplimiento ético y legal, especialmente respecto al RGPD y los archivos robots.txt, es fundamental para evitar bloqueos o sanciones.
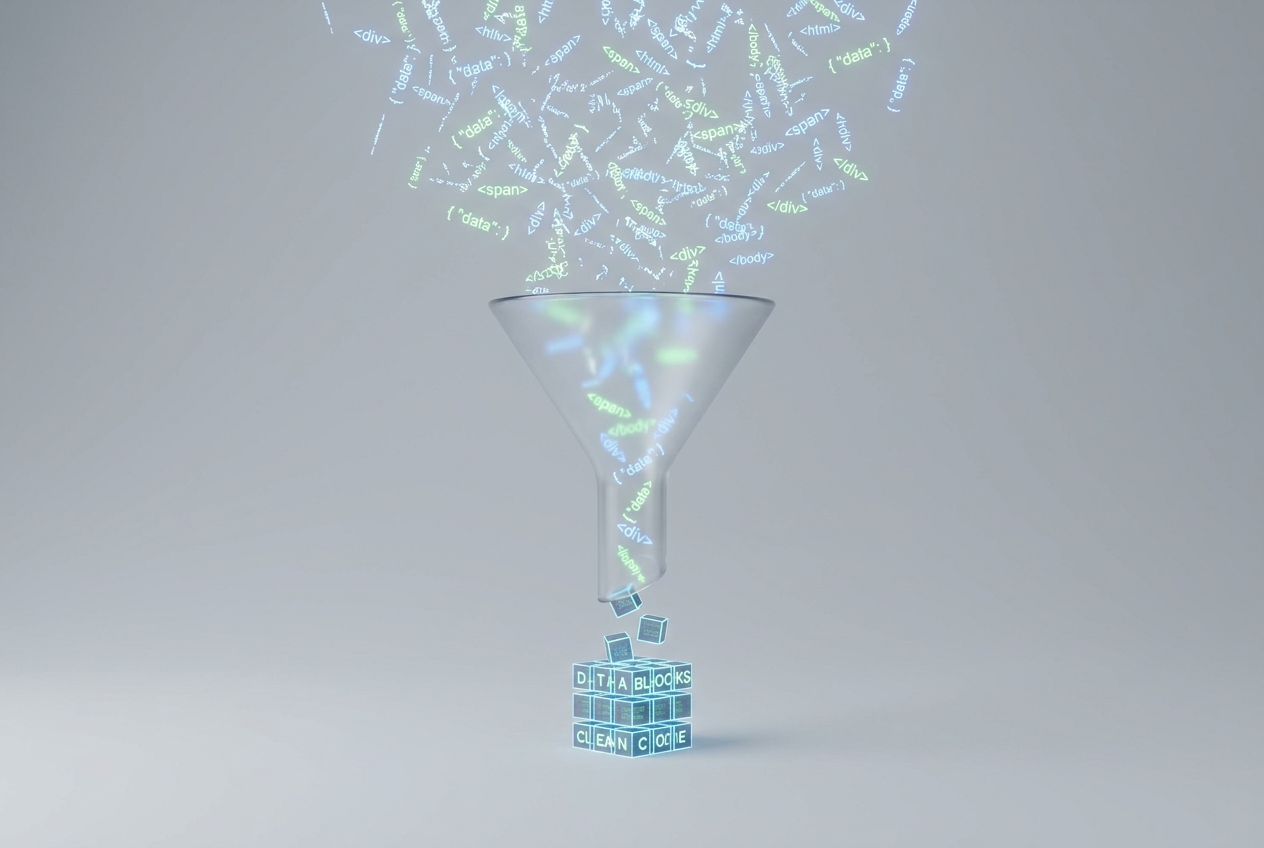
Seguro que te ha pasado: necesitas recopilar un montón de información de una web, pero los datos están esparcidos por todas partes o enterrados en tablas que no se dejan copiar fácilmente. Hacerlo a mano es un auténtico suplicio y una pérdida de tiempo monumental, especialmente cuando hablamos de cientos de páginas. Aquí es donde entra en juego el web scraping o raspado web, una técnica que básicamente consiste en automatizar la recolección de datos para convertirlos en algo útil, como una tabla de Excel o una base de datos SQL.
Lo mejor de todo es que ya no hace falta ser un hacha de la programación para lograrlo. Aunque antaño esto era terreno exclusivo de los desarrolladores que dominaban Python, hoy en día existen soluciones basadas en IA y extensiones muy intuitivas que permiten que cualquier persona, aunque no sepa escribir una sola línea de código, pueda extraer precios de la competencia, generar leads o hacer investigaciones de mercado en un abrir y cerrar de ojos.
Métodos tradicionales y accesibles para extraer datos
Si no quieres complicarte la vida y solo necesitas sacar una tabla sencilla de una página, hay trucos muy rápidos. Por ejemplo, Google Sheets tiene una función llamada IMPORTHTML que es una auténtica maravilla; solo le das la URL y el índice de la tabla, y ¡zas!, los datos aparecen en tu hoja de cálculo. También existen extensiones para Chrome que funcionan resaltando los elementos que te interesan y exportándolos directamente a CSV o XLSX, aunque suelen tener límites mensuales de páginas.
Para quienes buscan algo más robusto pero sin programar, herramientas como Power Query en Excel ofrecen una opción brillante. Gracias a la función de obtener datos de la web mediante ejemplos, puedes decirle al programa: «Mira, quiero este nombre y este precio», y el sistema, mediante algoritmos inteligentes, detecta el patrón y extrae el resto de los elementos similares de la página automáticamente.
La revolución del Scraping impulsado por Inteligencia Artificial
El problema de los extractores antiguos es que eran muy rígidos; si la web cambiaba un botón de sitio o una clase CSS, el script dejaba de funcionar y había que arreglarlo todo. Los scrapers con IA han venido a solucionar esto utilizando el aprendizaje automático para entender el contexto de la página. No buscan una etiqueta exacta, sino que reconocen patrones (como un precio o una dirección), lo que los hace mucho más flexibles y resistentes a los cambios de diseño.
- Octoparse y ScrapeStorm: Ideales para quienes huyen del código. Permiten configurar la extracción mediante clics o incluso usando diagramas de flujo para tareas complejas, ofreciendo rotación de IPs para no ser bloqueados.
- Browse AI: Se especializa en el monitoreo. Puedes entrenar a un «bot» para que vigile una web y te avise o actualice tus datos automáticamente cada cierto tiempo.
- Thunderbit y Bardeen: Herramientas muy versátiles que integran la extracción con flujos de trabajo automatizados, permitiendo incluso usar lenguaje natural para definir qué datos queremos rescatar.
- ScrapingBee y Import.io: Soluciones más orientadas a perfiles técnicos o empresas que manejan volúmenes masivos de datos y necesitan APIs personalizables para simular la navegación humana.
Desafíos técnicos y el muro del anti-scraping
No todo es tan sencillo como darle a un botón. Muchas webs modernas utilizan JavaScript para cargar contenido de forma dinámica, lo que significa que los datos no están ahí al cargar la página, sino que aparecen mientras haces scroll. Para combatir esto, los extractores avanzados usan renderizado de JavaScript y proxies para evitar que el servidor detecte que eres un bot y te lance un CAPTCHA o te bloquee la IP.
Además, existe el reto de la limpieza de datos. A veces, la información extraída viene con «ruido» (espacios extraños, etiquetas HTML mezcladas o formatos inconsistentes). Las herramientas modernas de IA ya incluyen funciones de limpieza automática, ahorrando horas de trabajo manual en la depuración de la base de datos final.
Ética, legalidad y buenas prácticas
Es fundamental no hacer las cosas a lo loco. El scraping puede rozar los límites legales si se usa para robar datos personales o contenido protegido. En la Unión Europea, el RGPD regula estrictamente la extracción de datos personales, por lo que es vital centrarse en información pública y no sensible.
Para hacer un raspado ético, lo primero es revisar el archivo robots.txt de la web, que es donde el dueño indica qué partes puede rastrear un bot y cuáles no. También es recomendable implementar retardos entre peticiones para no saturar el servidor ajeno y provocar una caída del servicio, lo cual sería una mala educación técnica y un riesgo para tu propia conexión.
Enfoques para programadores y perfiles técnicos
Si sabes programar, el control es total. Python es el rey indiscutible gracias a librerías como BeautifulSoup y urllib2, que permiten parsear el HTML y extraer exactamente lo que necesites. Para proyectos más ambiciosos, se pueden construir crawlers personalizados que naveguen sistemáticamente por miles de enlaces creando un índice propio.
Otra vía es utilizar las APIs oficiales que ofrecen plataformas como Facebook o X (Twitter). Aunque son más limitadas y a veces de pago, es la forma más legal y estable de obtener datos estructurados sin riesgo de que el sitio cambie su estructura y rompa tu código.
La capacidad de automatizar la recolección de información ha democratizado el acceso a los datos, permitiendo que desde un estudiante hasta una gran empresa optimicen sus decisiones. Ya sea mediante una simple fórmula de Google, una extensión rápida o un sofisticado sistema de IA con rotación de proxies, lo importante es elegir la herramienta que mejor se adapte al volumen de datos y a la complejidad del sitio objetivo, manteniendo siempre un respeto riguroso por la normativa legal y la estabilidad de los servidores consultados.