- La inferencia local elimina la dependencia de la nube, garantizando privacidad total y costes cero por token.
- Herramientas como Ollama y LM Studio facilitan el despliegue de modelos cuantizados GGUF en hardware doméstico.
- La memoria RAM y VRAM son los factores críticos para determinar qué tamaño de modelo puede ejecutar cada equipo.

Hace apenas un par de años, intentar montar un modelo de lenguaje potente en casa era una auténtica pesadilla. Te pasabas horas peleándote con las versiones de PyTorch, instalando dependencias de CUDA que no encajaban y gestionando cuantizaciones a mano, para que al final el chatbot fuera lentísimo y solo sirviera para hacer una demo rápida. Por suerte, esa época ya ha pasado y hoy contamos con una infraestructura madura donde todo fluye mucho mejor.
Actualmente, el panorama ha cambiado radicalmente. Ya no necesitas ser un experto en sistemas para tener una IA funcionando; existen aplicaciones que gestionan todo el ciclo, desde la descarga del modelo hasta la creación de un servidor API compatible con OpenAI, con tan solo un clic. El catálogo de modelos abiertos ha crecido exponencialmente, permitiéndonos elegir entre opciones como Llama, Gemma, Qwen o Mistral según lo que necesitemos en cada momento.

¿Qué implica realmente ejecutar una IA en local?
Cuando hablamos de IA local, nos referimos a que todo el proceso —los pesos del modelo, la inferencia y la gestión de tus prompts— ocurre dentro de tu propio hardware. No hay datos que viajen a servidores externos, por lo que tus conversaciones y documentos nunca llegan a manos de gigantes como Google o OpenAI. Esto es una bendición para quienes manejan datos bajo acuerdos de confidencialidad (NDA), expedientes médicos o código propietario de empresa que no puede salir de la red interna.
Además de la privacidad, hay otros puntos fuertes. Por un lado, el cumplimiento del RGPD es inmediato, ya que no hay transferencias internacionales de datos. Por otro, te olvidas de las facturas mensuales por millón de tokens; una vez que tienes el PC, el uso es totalmente gratuito. También es la solución ideal para trabajar en modo offline, ya sea en un avión o en zonas con una conexión internet que deja mucho que desear. Eso sí, hay que ser realistas: los modelos cerrados de vanguardia siguen teniendo una capacidad de razonamiento complejo superior, por lo que lo más inteligente es combinar ambos mundos según la tarea.
El hardware: la clave está en la memoria
Si hay algo que debes grabar a fuego es que los LLMs son auténticos glotones de memoria. Sin embargo, ya no todo depende de tener una tarjeta gráfica carísima. Gracias a avances como llama.cpp, ahora podemos aprovechar mucho mejor la CPU y la RAM del sistema.
Ecosistema Apple Silicon
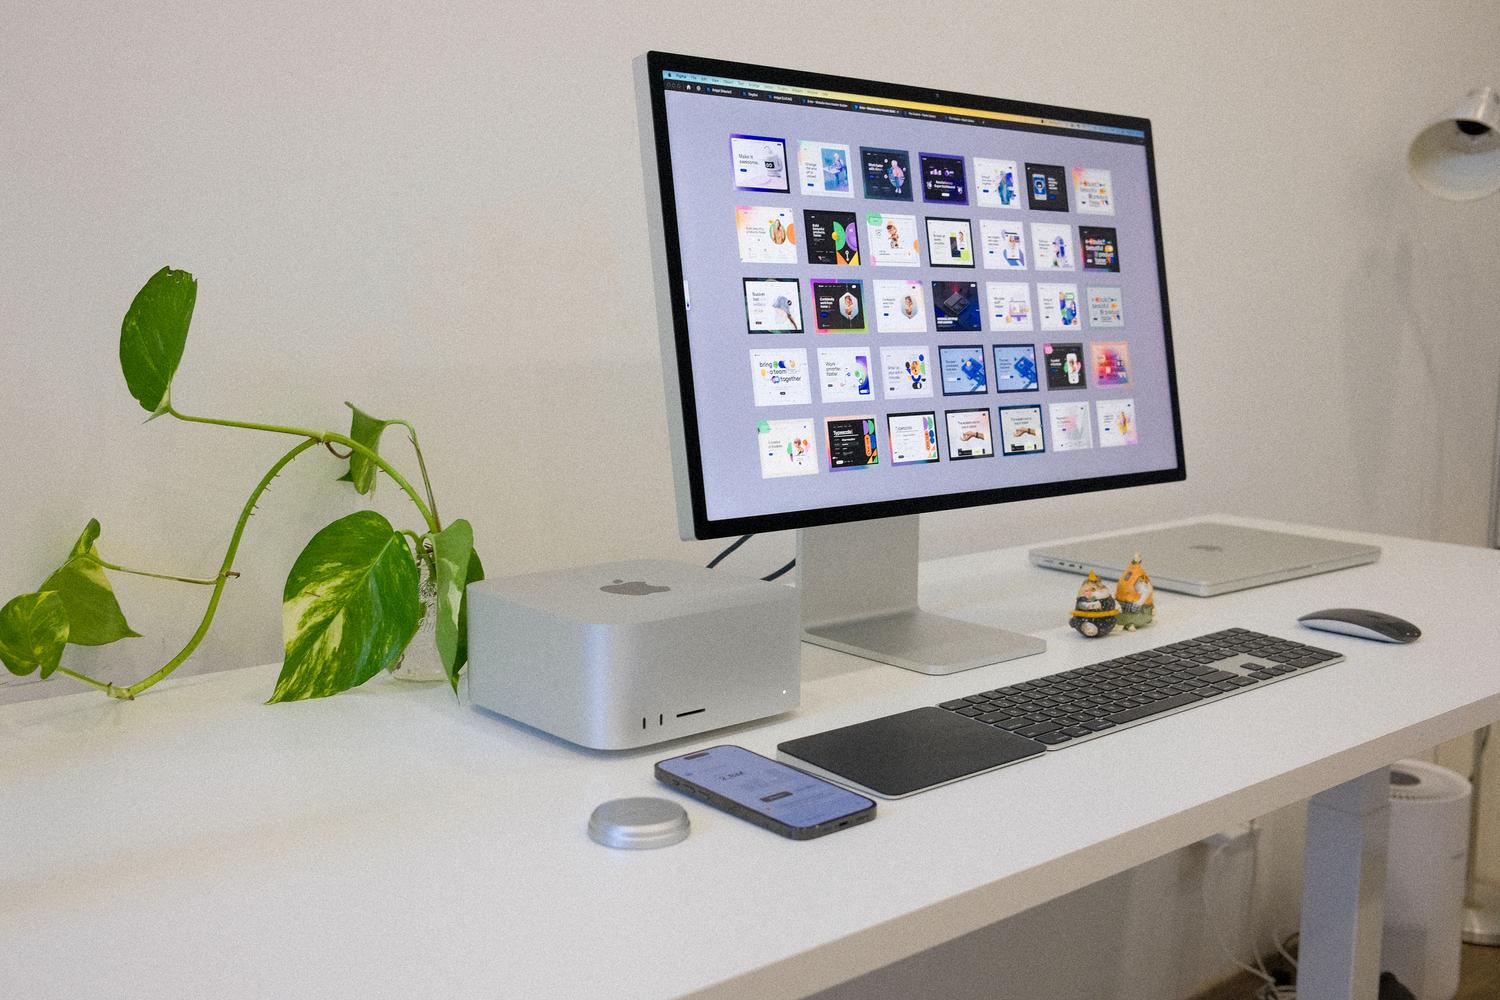
Los Mac con chips M son, posiblemente, la opción más eficiente para laptops debido a su arquitectura de memoria unificada. Esto permite que la GPU acceda a toda la RAM del sistema sin tener que copiar datos, lo que les da una ventaja brutal. Por ejemplo, un equipo con 16 GB puede mover modelos de hasta 8B parámetros cómodamente, mientras que los modelos Max con 64 GB o más pueden ejecutar modelos de hasta 70B con cuantizaciones agresivas, acercándose a la calidad de modelos profesionales en casa.
PC con GPU dedicada
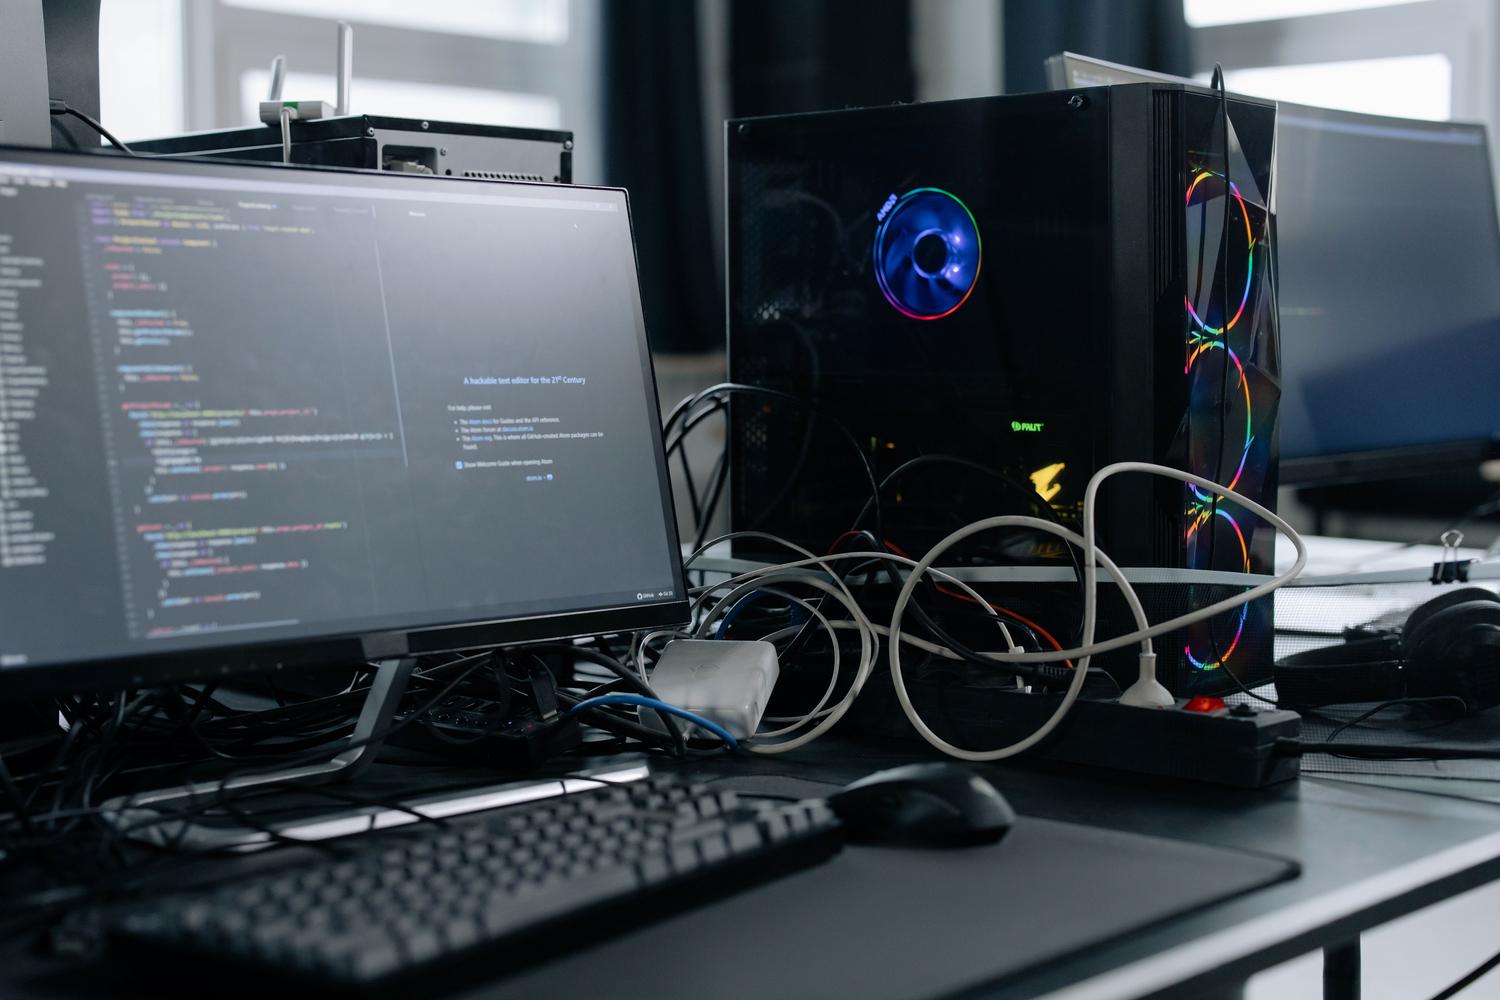
En el mundo Windows o Linux, el rey es la VRAM de la tarjeta gráfica. Si tienes una RTX 3060 de 12 GB o una 4060 Ti de 16 GB, puedes manejar modelos de 7B a 13B sin problemas. Para quienes buscan potencia bruta, una RTX 4090 con 24 GB de VRAM es la joya de la corona, permitiendo correr modelos de 30B sin cuantizar o modelos de 70B optimizados. Si vas a montar un equipo desde cero, lo más equilibrado hoy en día es un Mac mini M4 Pro con 48 GB o un PC con una RTX 4070 Super.
Herramientas imprescindibles: CLI, GUI y Runtimes
Para poner en marcha la IA, tenemos varias rutas dependiendo de cuánta fricción queramos en el proceso.
- Ollama: Es el motor preferido de muchos. Es un runtime ligero que funciona principalmente vía CLI y ofrece una API REST compatible con OpenAI. Es ideal si buscas rapidez y simplicidad para servir modelos en segundo plano y conectar otras apps a través del puerto 11434.
- LM Studio: Para quienes huyen de la terminal, esta es la mejor opción. Ofrece una interfaz visual impecable, un catálogo donde puedes ver los ratings de los modelos y un servidor local integrado. En Mac, destaca por usar el motor MLX de Apple, logrando velocidades superiores a llama.cpp.
- Jan: Una alternativa open-source y auditable que permite alternar entre modelos locales y APIs en la nube (BYOK), aunque suele ser un poco menos pulida que LM Studio.
- llama.cpp: Es el motor base en C++ que hace que todo lo anterior funcione. Si eres un usuario avanzado y quieres exprimir hasta el último porcentaje de rendimiento ajustando flags, ve directo a la fuente.
Entendiendo los modelos y el formato GGUF
Para que un modelo gigante quepa en un ordenador doméstico, se utiliza la cuantización, que básicamente comprime los pesos del modelo. El formato estándar para esto es el GGUF, que empaqueta todo lo necesario (pesos, tokenizador y metadatos) en un solo archivo. Una cuantización Q4_K_M suele ser el punto dulce, ya que reduce el tamaño del modelo en un 70% manteniendo una calidad casi idéntica al modelo original.
A la hora de elegir, los modelos de 7B u 8B parámetros son el estándar para uso general en máquinas con 16 GB de RAM. Si necesitas algo más especializado, existen variantes para código o razonamiento matemático. Lo ideal es empezar con una cuantización Q5 o Q6, y bajar a Q4 solo si notas que la memoria se queda corta y el sistema empieza a ir lento.
Integración en el flujo de trabajo y desarrollo
Tener el modelo corriendo es solo el principio. Para que sea útil en el día a día, conviene usar clientes de escritorio como Cherry Studio, Msty o Levante. Estas herramientas permiten gestionar el historial de chats, usar prompts reutilizables y conectar servidores MCP para que la IA acceda a tus correos, Slack o GitHub. Además, permiten saltar entre un modelo local y uno de nube en la misma conversación, usando el local para datos sensibles y el de nube para tareas de razonamiento extremo.
Para los desarrolladores, existen librerías como OllamaSharp o LlamaSharp que permiten integrar estas capacidades directamente en aplicaciones de C#. Puedes optar por hacer llamadas HTTP a un servidor de Ollama o cargar el modelo directamente en la memoria de tu aplicación usando el backend de CPU, eliminando cualquier dependencia de servicios externos.
A nivel empresarial, la cosa escala. No puedes pedirle a cada empleado que gestione su propia instancia de Ollama. Lo lógico es montar un servidor de inferencia centralizado con hardware potente (como estaciones con doble A6000) y gestionar el acceso mediante una plataforma que controle los logs, los límites de uso y la seguridad de los datos, manteniendo así el control total de la infraestructura.
Tener una IA local en la actualidad es una decisión inteligente para cualquiera que valore la privacidad o quiera evitar los costes recurrentes de las suscripciones. Desde la sencillez de instalar Ollama y bajar un modelo Llama en diez minutos, hasta la complejidad de hacer un fine-tuning con datos propios para crear un especialista en un dominio concreto, las posibilidades son enormes. Aunque los modelos cerrados sigan liderando la frontera tecnológica, la brecha se cierra y el ecosistema de herramientas GUI y CLI hace que tener el cerebro de la IA en tu propio disco duro sea más accesible y potente que nunca.