- El aprendizaje federado permite entrenar modelos de inteligencia artificial sin mover los datos de su origen, garantizando la privacidad total.
- Existen modalidades horizontales, verticales y por transferencia según cómo se distribuyan los atributos y las muestras entre los nodos.
- Su aplicación es crucial en sectores sensibles como la sanidad, las finanzas y la conducción autónoma para cumplir normativas como el RGPD.

Seguro que has oído hablar de la inteligencia artificial, pero quizá no sepas que hay una forma de entrenarla sin que tus datos personales tengan que viajar a ninguna nube sospechosa. El aprendizaje federado llega precisamente para romper con el esquema tradicional de recolectar todo en un servidor central, proponiendo que sea el modelo el que viaje hacia donde están los datos y no al revés. Es, básicamente, una manera de aprender de forma colectiva sin tener que desnudarse digitalmente.
Esta arquitectura no es solo una curiosidad técnica, sino que se ha convertido en la pieza clave para que las empresas puedan innovar mientras cumplen a rajatabla con leyes tan estrictas como el RGPD europeo. En lugar de crear un gran repositorio que podría ser el blanco perfecto para un ciberataque, se opta por un sistema descentralizado donde la soberanía de la información permanece en manos del usuario o de la institución que la generó, logrando un equilibrio muy canela entre la precisión del algoritmo y el derecho a la intimidad.
¿En qué consiste realmente este sistema?
Para que nos entendamos, el principio básico es entrenar algoritmos, como las redes neuronales profundas, en múltiples dispositivos (nodos) para construir un modelo global robusto. La magia ocurre cuando cada nodo entrena el modelo con sus propios datos locales y luego solo intercambia los parámetros, como los pesos de la red, evitando el envío de muestras reales. Esto lo diferencia del aprendizaje distribuido, que busca paralelizar la potencia de cálculo en centros de datos potentes, mientras que el federado se enfrenta a la heterogeneidad de los datos y a dispositivos que pueden fallar o quedarse sin batería en cualquier momento.
Arquitecturas: Del mando central a la autonomía total
No todos los sistemas federados funcionan igual. Por un lado, tenemos el enfoque centralizado, donde un servidor actúa como director de orquesta, coordinando quién participa y agregando las actualizaciones. El problema es que este servidor puede volverse un cuello de botella. Para evitarlo, existen los algoritmos descentralizados, que utilizan una topología de red peer-to-peer donde los nodos se coordinan entre sí, eliminando la dependencia de una entidad única, aunque esto añada cierta complejidad al proceso de aprendizaje.
En algunos casos más avanzados, se integran contratos inteligentes y blockchain. Aquí, el contrato actúa como el ejecutor automático del proceso iterativo, y los nodos compiten resolviendo problemas matemáticos para validar nuevos bloques. Esto añade una capa de transparencia y seguridad brutal, ya que la optimización de los parámetros queda registrada de forma inmutable.
Tipos de Aprendizaje Federado según los datos
- Aprendizaje Federado Horizontal: Se da cuando los nodos comparten el mismo esquema de datos pero tienen diferentes muestras. Es el ejemplo clásico del teclado predictivo de los móviles: todos usamos las mismas funciones de escritura, pero cada uno escribe cosas distintas.
- Aprendizaje Federado Vertical: Aquí ocurre lo contrario; los nodos tienen las mismas muestras (por ejemplo, el mismo paciente) pero diferentes atributos (uno tiene el historial clínico y otro las pruebas radiológicas). Se usan técnicas de computación segura multi-parte para cruzar los datos sin revelar la identidad del sujeto.
- Aprendizaje por Transferencia Federado: Se utiliza el conocimiento de un dominio para mejorar otro relacionado. Sirve para adaptar modelos generales a nichos muy específicos, como llevar una IA médica global a las particularidades de un hospital concreto.
El ciclo de vida de una ronda de entrenamiento
Para que el modelo final sea decente, el proceso se divide en ciclos llamados rondas. Primero ocurre la inicialización y selección, donde el servidor elige un subconjunto de nodos candidatos. Después viene la configuración, donde se envía el modelo global actual a los elegidos. Finalmente, llega la fase de informes y agregación: los nodos entrenan localmente y envían sus actualizaciones, que el servidor promedia (usando técnicas como FedAvg) para actualizar el modelo global. Si demasiados nodos fallan o tardan, la ronda se descarta para no viciar el resultado.
Retos técnicos: Datos no-IID y heterogeneidad
No todo es color de rosa. Uno de los mayores quebraderos de cabeza es que los datos no suelen estar distribuidos de forma idéntica e independiente (no-IID). Esto puede provocar un desplazamiento de covariantes (diferentes formas de escribir una letra) o un desequilibrio de muestras, donde algunos nodos tienen muchísima más información que otros, sesgando el modelo. Para solucionar esto, se aplican optimizadores como FedProx o técnicas de clustering para agrupar nodos con distribuciones similares.
Además, está la heterogeneidad del sistema. No es lo mismo entrenar en un servidor de última generación que en un dispositivo IoT con poca memoria. Marcos como HeteroFL permiten que los modelos locales varíen en complejidad según la capacidad de cómputo del dispositivo, sin dejar de alimentar un único modelo de inferencia global.
Aplicaciones que están cambiando el juego
Este paradigma es oro puro en sectores donde la privacidad es sagrada. En el ámbito sanitario, permite que varios hospitales colaboren en la detección de enfermedades sin que los expedientes de los pacientes salgan de sus centros. En el sector financiero, los bancos pueden detectar fraudes analizando patrones comunes sin exponer los datos transaccionales de sus clientes.
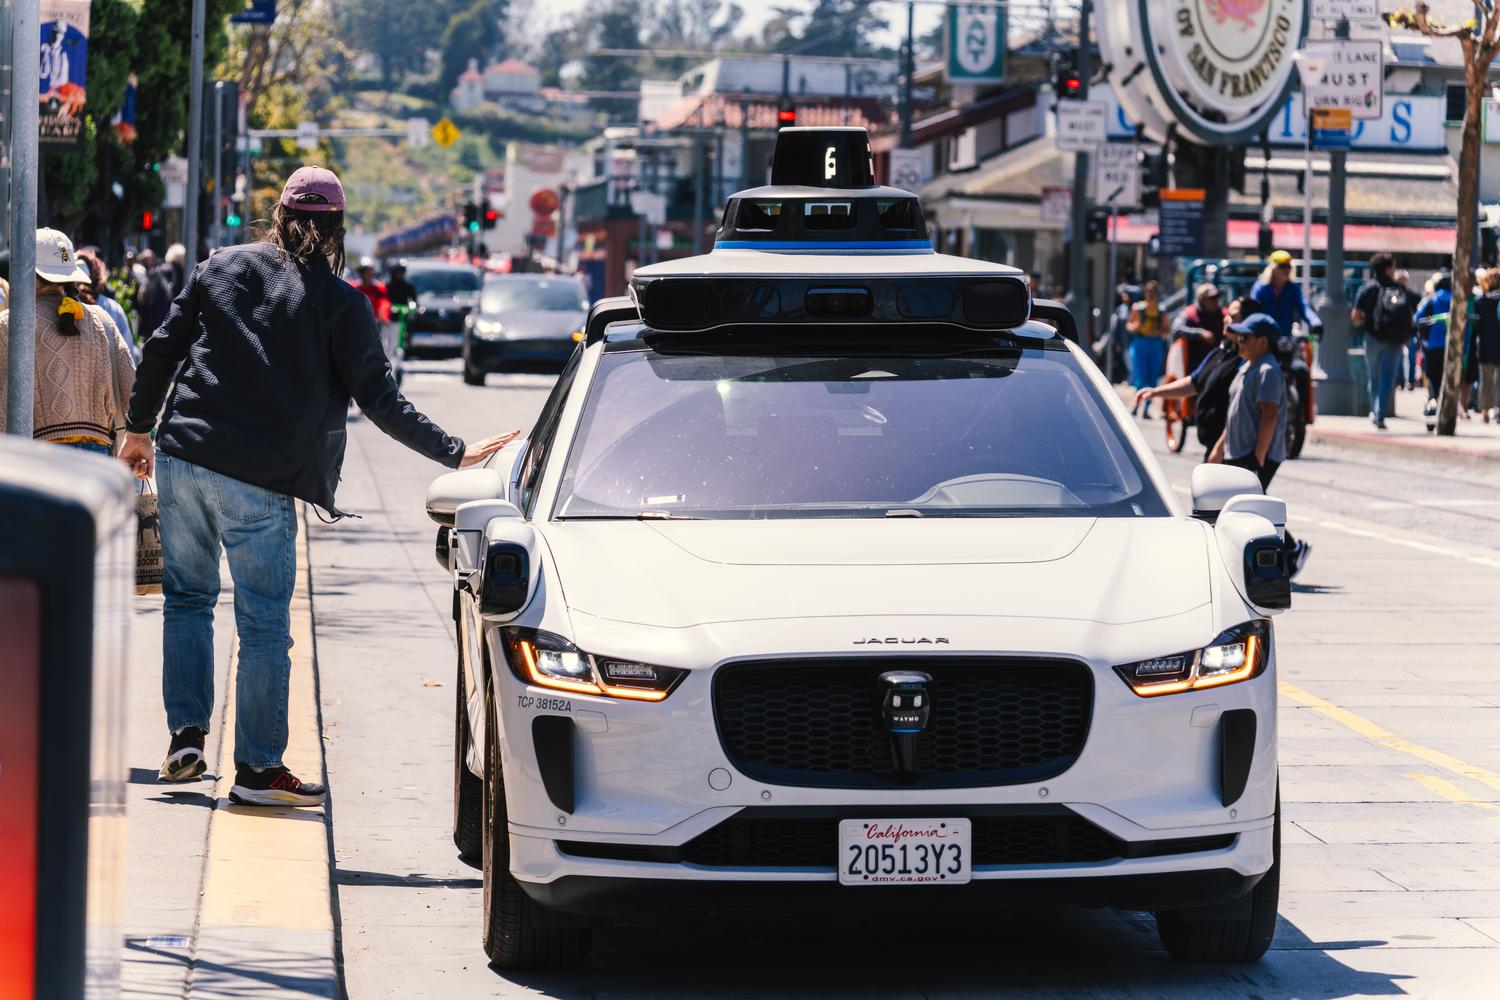
Tampoco podemos olvidar la conducción autónoma. Para que un coche reaccione en milisegundos, no puede depender de una respuesta de la nube. El aprendizaje federado permite que los vehículos aprendan de sus entornos locales y compartan mejoras de seguridad, reduciendo el tráfico de datos y minimizando los riesgos de latencia que podrían causar accidentes.
Consideraciones sobre equidad y sesgos
Es importante notar que el aprendizaje federado puede introducir nuevos sesgos. Por ejemplo, si el servidor cierra una ronda al mediodía en España, los usuarios de Los Ángeles estarán durmiendo y sus dispositivos (que suelen entrenar solo al estar cargando y en WiFi) no participarán. Esto crea una infrarrepresentación demográfica. Por ello, la investigación actual se centra en crear incentivos para la participación y algoritmos que garanticen la equidad algorítmica, evitando que los nodos más potentes dominen el modelo global.
La capacidad de procesar información en el borde de la red, combinando el FL con la computación periférica, permite que la inteligencia artificial sea más democrática, segura y eficiente. Al final, se trata de aprovechar el poder del dato colectivo sin sacrificar la libertad individual, transformando la minería de datos en un proceso colaborativo y respetuoso que impulsa la innovación tecnológica sin dejar atrás la ética de la privacidad.
Índice
- 1 ¿En qué consiste realmente este sistema?
- 2 Arquitecturas: Del mando central a la autonomía total
- 3 Tipos de Aprendizaje Federado según los datos
- 4 El ciclo de vida de una ronda de entrenamiento
- 5 Retos técnicos: Datos no-IID y heterogeneidad
- 6 Aplicaciones que están cambiando el juego
- 7 Consideraciones sobre equidad y sesgos