- يؤدي الاستدلال المحلي إلى التخلص من الاعتماد على السحابة، مما يضمن الخصوصية الكاملة وعدم وجود تكاليف للرموز المميزة.
- تسهل أدوات مثل Ollama و LM Studio نشر نماذج GGUF الكمية على الأجهزة المنزلية.
- تعتبر ذاكرة الوصول العشوائي (RAM) وذاكرة الوصول العشوائي للفيديو (VRAM) من العوامل الحاسمة في تحديد حجم النموذج الذي يمكن لكل جهاز كمبيوتر تشغيله.

قبل بضع سنوات فقط، كانت محاولة بناء نموذج لغوي قوي داخليًا كابوسًا حقيقيًا. كنت تقضي ساعات في التعامل مع إصدارات PyTorch المختلفة ، وتثبيت تبعيات CUDA غير المتوافقة، وإدارة عمليات التكميم يدويًا، لتنتهي في النهاية ببرنامج دردشة بطيء للغاية ولا يصلح إلا لعرض توضيحي سريع. لحسن الحظ، ولّى ذلك الزمن، واليوم لدينا بنية تحتية متطورة تعمل فيها جميع الأنظمة بسلاسة أكبر.
اليوم، تغير المشهد بشكل جذري. لم يعد من الضروري أن تكون خبيرًا في الأنظمة لتشغيل الذكاء الاصطناعي؛ فهناك تطبيقات تدير الدورة بأكملها، بدءًا من تحميل النموذج وصولًا إلى إنشاء خادم واجهة برمجة تطبيقات متوافق مع OpenAI، بنقرة واحدة فقط . وقد نما فهرس النماذج المفتوحة بشكل هائل، مما يتيح لنا الاختيار من بين خيارات مثل Llama وGemma وQwen وMistral حسب احتياجاتنا في أي وقت.

ما الذي يستلزمه تشغيل الذكاء الاصطناعي محلياً في الواقع؟
عندما نتحدث عن الذكاء الاصطناعي المحلي، فإننا نعني أن العملية برمتها - من ترجيح النموذج والاستدلال إلى إدارة الرسائل - تتم داخل أجهزتك الخاصة . لا تنتقل أي بيانات إلى خوادم خارجية، وبالتالي لا تصل محادثاتك ومستنداتك إلى شركات عملاقة مثل جوجل أو OpenAI. يُعد هذا ميزةً قيّمةً لمن يتعاملون مع بيانات تخضع لاتفاقيات عدم إفصاح ، أو سجلات طبية، أو شفرة برمجية خاصة بالشركة لا يمكن نقلها خارج الشبكة الداخلية.
إلى جانب الخصوصية، توجد مزايا أخرى. أولًا، الامتثال الفوري للائحة العامة لحماية البيانات (GDPR) لعدم وجود عمليات نقل بيانات دولية. ثانيًا، يمكنك نسيان الفواتير الشهرية لكل مليون رمز مميز؛ فبمجرد امتلاكك لجهاز الكمبيوتر، يصبح استخدامه مجانيًا تمامًا. كما أنه الحل الأمثل للعمل دون اتصال بالإنترنت، سواءً على متن طائرة أو في مناطق ذات اتصال إنترنت ضعيف. مع ذلك، دعونا نكون واقعيين: لا تزال الأنظمة المغلقة المتطورة تتمتع بقدرات استدلال معقدة فائقة ، لذا فإن النهج الأمثل هو الجمع بين كلا النظامين حسب المهمة.
المكونات المادية: يكمن السر في الذاكرة
إذا كان هناك شيء واحد يجب أن تتذكره، فهو أن وحدات معالجة الرسومات منخفضة المستوى (LLMs) تستهلك الكثير من الذاكرة. مع ذلك، لم يعد الأمر مقتصراً على امتلاك بطاقة رسومات باهظة الثمن. بفضل التطورات مثل llama.cpp ، أصبح بإمكاننا الآن الاستفادة بشكل أفضل بكثير من وحدة المعالجة المركزية (CPU) وذاكرة الوصول العشوائي (RAM) للنظام.
نظام أبل سيليكون البيئي
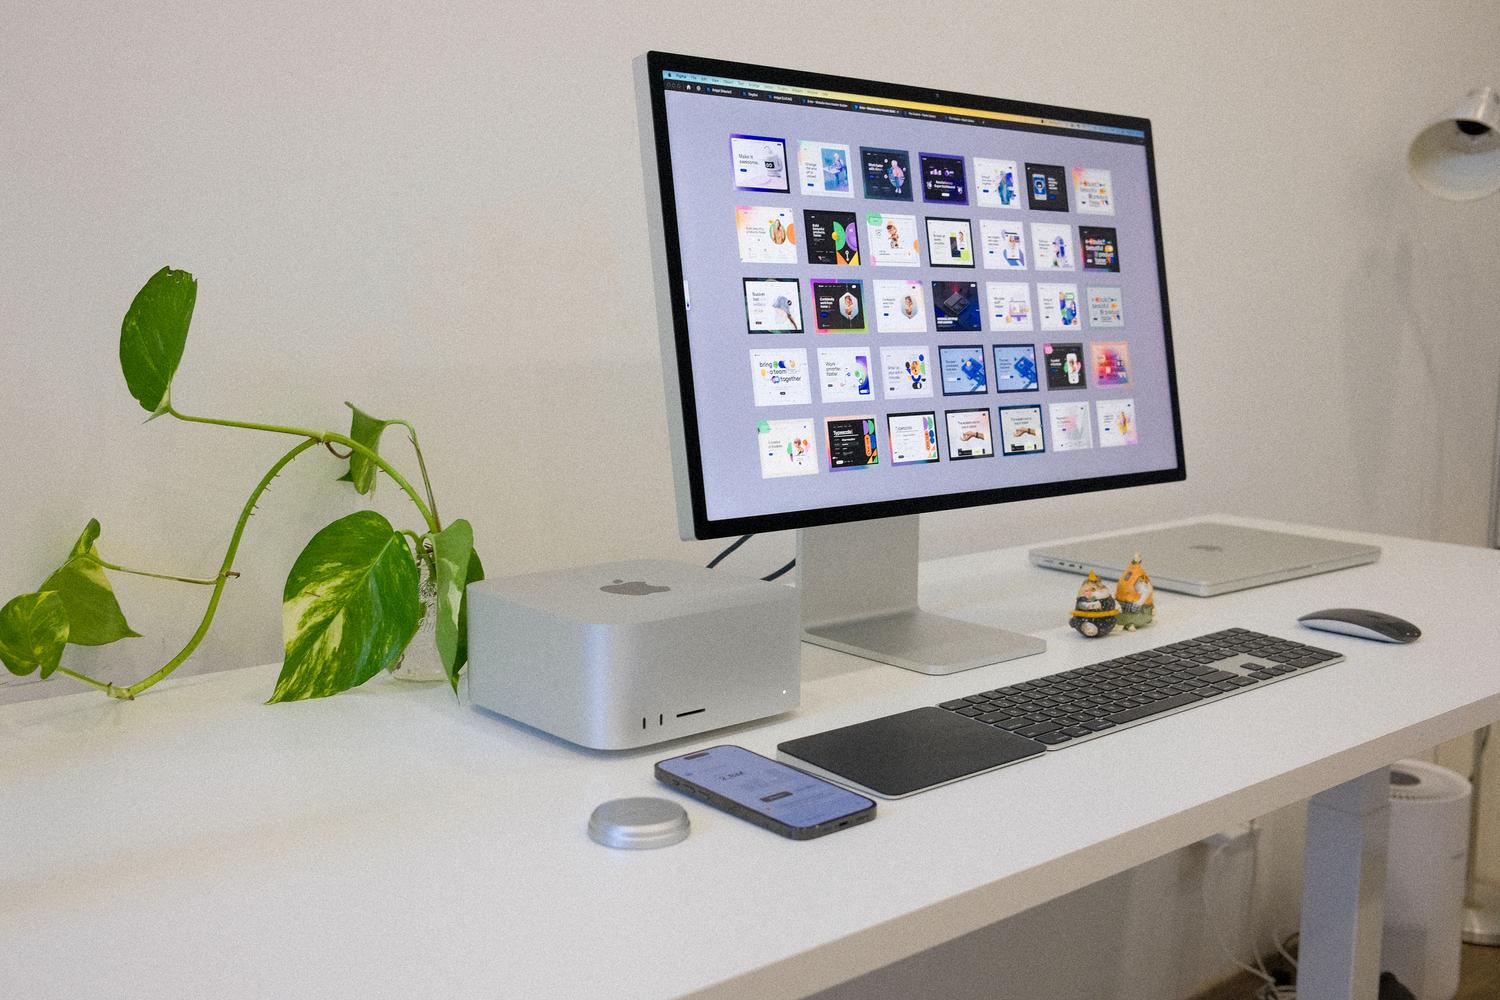
تُعتبر أجهزة ماك المزودة بمعالجات من سلسلة M الخيار الأمثل من حيث كفاءة استهلاك الطاقة، وذلك بفضل بنية الذاكرة الموحدة . يتيح هذا التصميم لوحدة معالجة الرسومات الوصول إلى جميع بيانات ذاكرة الوصول العشوائي (RAM) دون الحاجة إلى نسخها، مما يمنحها ميزة كبيرة. على سبيل المثال، يمكن لجهاز بسعة 16 جيجابايت تشغيل نماذج تصل إلى 8 بايت من المعاملات بسلاسة، بينما تستطيع طرازات Max المزودة بذاكرة 64 جيجابايت أو أكثر تشغيل نماذج تصل إلى 70 بايت من المعاملات باستخدام تقنية التكميم المتقدمة، ما يُقارب جودة النماذج الاحترافية للاستخدام المنزلي.
جهاز كمبيوتر مزود بوحدة معالجة رسومات مخصصة
في عالم ويندوز أو لينكس، تُعدّ ذاكرة الوصول العشوائي للفيديو (VRAM) العامل الأهم. فإذا كنت تمتلك بطاقة رسومات RTX 3060 بسعة 12 جيجابايت أو 4060 Ti بسعة 16 جيجابايت، يمكنك تشغيل نماذج تتراوح سعتها بين 7 و13 بايت بسلاسة. أما لمن يبحث عن أداء فائق، فإن بطاقة RTX 4090 بذاكرة VRAM سعة 24 جيجابايت هي الخيار الأمثل، حيث تتيح لك تشغيل نماذج 30 بايت غير مُكمّمة أو نماذج 70 بايت مُحسّنة. وإذا كنت تُنشئ نظامًا من الصفر، فإن الخيار الأكثر توازنًا اليوم هو جهاز Mac mini M4 Pro بذاكرة 48 جيجابايت أو جهاز كمبيوتر مزود ببطاقة RTX 4070 Super.
الأدوات الأساسية: واجهة سطر الأوامر، واجهة المستخدم الرسومية، وبيئات التشغيل
لتطبيق الذكاء الاصطناعي، لدينا عدة مسارات تعتمد على مقدار الاحتكاك الذي نريده في العملية.
- أولاما: إنه المحرك المفضل لدى الكثيرين. إنه بيئة تشغيل خفيفة الوزن تعمل بشكل أساسي عبر واجهة سطر الأوامر (CLI) وتوفر واجهة برمجة تطبيقات REST متوافقة مع OpenAI. إنه مثالي إذا كنت تبحث عن السرعة والبساطة لتقديم النماذج في الخلفية وربط التطبيقات الأخرى عبر المنفذ 11434.
- ستوديو إل إم: بالنسبة لمن يتجنبون استخدام سطر الأوامر، فهذا هو الخيار الأمثل. فهو يوفر واجهة رسومية سلسة، وفهرسًا يمكنك من خلاله الاطلاع على تقييمات الطرازات، وخادمًا محليًا مدمجًا. على نظام ماك، يتميز بسهولة استخدامه لـ محرك MLX من Apple، محققاً سرعات أعلى من llama.cpp.
- يناير: بديل مفتوح المصدر وقابل للتدقيق يسمح بالتبديل بين النماذج المحلية وواجهات برمجة التطبيقات السحابية (BYOK)، على الرغم من أنه يميل إلى أن يكون أقل صقلًا من LM Studio.
- لاما.cpp: إنه محرك C++ الأساسي الذي يجعل كل شيء آخر يعمل. إذا كنت مستخدمًا متقدمًا وترغب في استخراج أقصى أداء ممكن منه عن طريق تعديل الخيارات، فانتقل مباشرةً إلى شفرة المصدر.
فهم نماذج وتنسيق GGUF
لتحسين أداء نموذج كبير الحجم على جهاز كمبيوتر منزلي، تُستخدم تقنية التكميم ، التي تعمل أساسًا على ضغط أوزان النموذج. الصيغة القياسية لذلك هي GGUF ، التي تجمع كل ما هو ضروري (الأوزان، والمُجزئ، والبيانات الوصفية) في ملف واحد. عادةً ما يكون التكميم Q4_K_M هو الخيار الأمثل، حيث يُقلل حجم النموذج بنسبة 70% مع الحفاظ على جودة تكاد تكون مطابقة للنموذج الأصلي.
عند الاختيار، تُعدّ نماذج المعاملات 7B أو 8B هي المعيار للاستخدام العام على الأجهزة المزودة بذاكرة وصول عشوائي (RAM) سعتها 16 جيجابايت. إذا كنت بحاجة إلى شيء أكثر تخصصًا، فهناك إصدارات مخصصة للبرمجة أو الاستدلال الرياضي. يُنصح بالبدء بتكميم Q5 أو Q6، واللجوء إلى Q4 فقط في حال ملاحظة انخفاض الذاكرة وبدء تباطؤ النظام.
التكامل في سير العمل والتطوير
تشغيل النموذج ليس سوى البداية. لجعله مفيدًا في الاستخدام اليومي، يُنصح باستخدام برامج سطح المكتب مثل Cherry Studio أو Msty أو Levante . تتيح لك هذه الأدوات إدارة سجل المحادثات، واستخدام عبارات قابلة لإعادة الاستخدام، وربط خوادم MCP ليتمكن الذكاء الاصطناعي من الوصول إلى بريدك الإلكتروني أو Slack أو GitHub. علاوة على ذلك، تتيح لك التبديل بين نموذج محلي ونموذج سحابي ضمن المحادثة نفسها، باستخدام النموذج المحلي للبيانات الحساسة والنموذج السحابي لمهام الاستدلال المعقدة.
بالنسبة للمطورين، تتيح مكتبات مثل OllamaSharp أو LlamaSharp دمج هذه الإمكانيات مباشرةً في تطبيقات C#. يمكنك اختيار إجراء استدعاءات HTTP إلى خادم Ollama أو تحميل النموذج مباشرةً في ذاكرة تطبيقك باستخدام وحدة المعالجة المركزية، مما يلغي أي اعتماد على خدمات خارجية.
على مستوى المؤسسات، تتوسع الأمور. لا يمكنك أن تطلب من كل موظف إدارة نسخة Ollama الخاصة به. الحل الأمثل هو إنشاء خادم استدلال مركزي مزود بأجهزة قوية (مثل محطات عمل بمعالجين A6000) وإدارة الوصول من خلال منصة تتحكم في السجلات وحدود الاستخدام وأمن البيانات، مما يضمن التحكم الكامل في البنية التحتية.
يُعدّ امتلاك الذكاء الاصطناعي محليًا خيارًا ذكيًا لكل من يُقدّر الخصوصية أو يرغب في تجنّب تكاليف الاشتراكات المتكررة. بدءًا من سهولة تثبيت Ollama وتنزيل نموذج Llama في غضون عشر دقائق، وصولًا إلى تعقيد ضبطه بدقة باستخدام بياناتك الخاصة لإنشاء خبير في مجال مُحدد، فالإمكانيات واسعة. ورغم أن النماذج مغلقة المصدر لا تزال تتصدر المشهد التكنولوجي، إلا أن الفجوة تتقلص، كما أن منظومة أدوات واجهة المستخدم الرسومية وواجهة سطر الأوامر تجعل امتلاك ذكاء اصطناعي على قرصك الصلب أكثر سهولة وقوة من أي وقت مضى.