- HBM 記憶體採用 3D 堆疊設計和超寬匯流排,因此具有巨大的頻寬和更低的功耗。
- 它的演進(HBM、HBM2、HBM2E、HBM3 和 HBM-PIM)提高了人工智慧和超級運算的容量、速度和效率。
- 與 GDDR 相比,HBM 效率更高、體積更小,但製造成本更高、更複雜,因此通常用於高階 GPU。
- HBM 在 NVIDIA H100 或 AMD Instinct 等加速器中至關重要,能夠處理大規模 AI 和 HPC 工作負載。
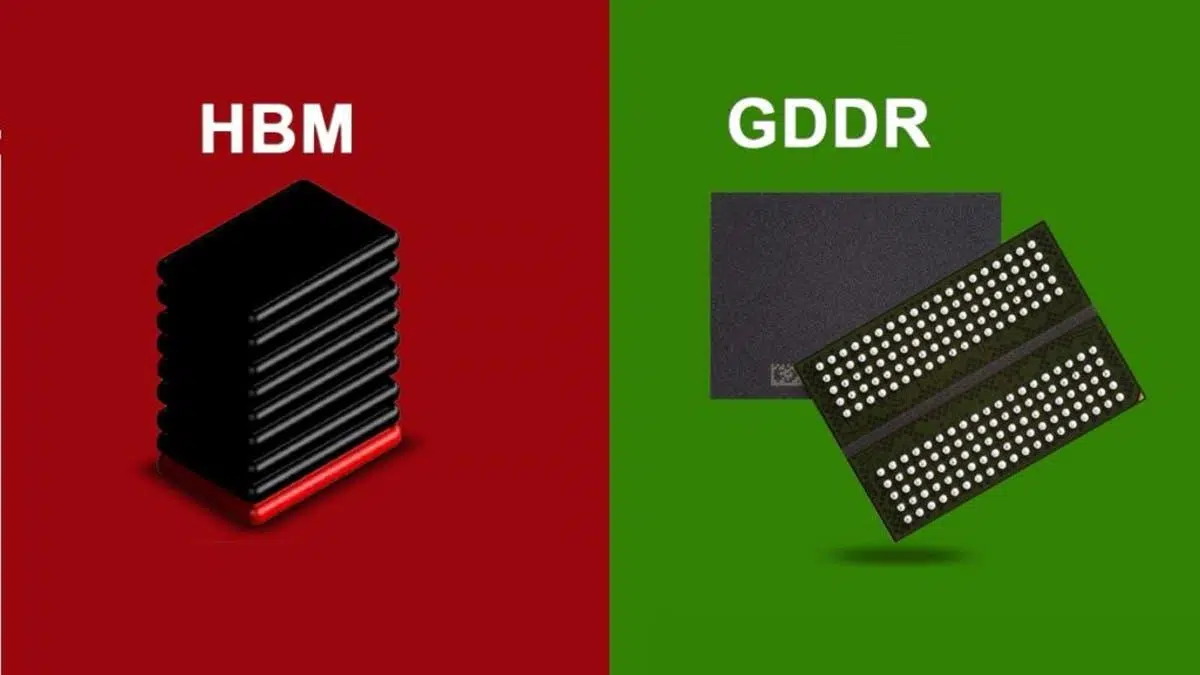
在討論顯示卡、人工智慧和超級運算領域的極致效能時,關鍵因素不僅在於GPU的效能,還在於它所使用的記憶體類型。近年來,HBM(高頻寬記憶體)憑藉其處理大量資料且功耗極低的優勢,已成為核心元件。
HBM 記憶體並非傳統 RAM 的簡單升級,而是一種全新的架構,從設計初就旨在提供超大頻寬、極小尺寸和高效率。以下將深入解釋 HBM 的定義、工作原理、與 GDDR 的差異、發展歷程(HBM、HBM2、HBM2E、HBM3 和 PIM 等變體),以及它為何在 NVIDIA H100 或 AMD Instinct MI300X 等 GPU 中變得至關重要。
什麼是HBM記憶體?它與其他DRAM有何不同?
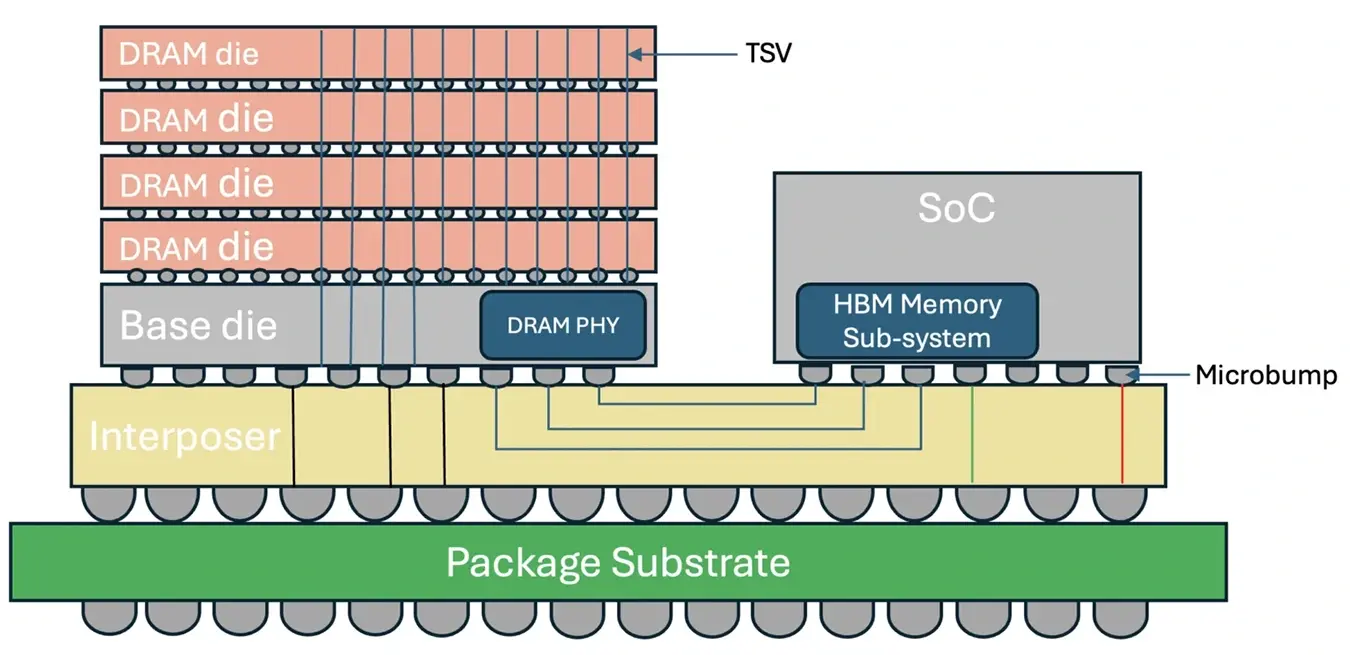
HBM,即高頻寬記憶體(High Bandwidth Memory)的縮寫,是一種高速DRAM,旨在以極小的物理空間提供巨大的頻寬,並且功耗遠低於DDR4或GDDR5/GDDR6。與GDDR記憶體將多個晶片放置在處理器周圍不同,HBM是由垂直堆疊的DRAM晶片組成,這些晶片安裝在單一基板上。
每個HBM堆疊由多個DRAM晶片堆疊而成,早期版本通常最多有八層,但新標準允許更多層。這些晶片透過矽通孔(TSV)和微焊接相互連接,從而實現層間垂直通信,延遲極低,並可實現數千個並行連接。
為了將這些記憶體堆疊連接到GPU或CPU,通常會使用矽中介層——位於GPU和HBM堆疊下方的高密度「橋樑」。這種中介層可以實現非常短且寬的資料路徑,引腳數量遠超傳統PCB,但代價是顯著增加了封裝的複雜性和製造成本。
與傳統DRAM優先考慮高頻和相對較窄的匯流排不同,HBM的設計概念恰恰相反:中等頻率,極寬匯流排。這在無需顯著提高時脈頻率的情況下實現了巨大的總頻寬,從而降低了發熱量,提高了能源效率。
HBM記憶體堆疊的內部組織結構
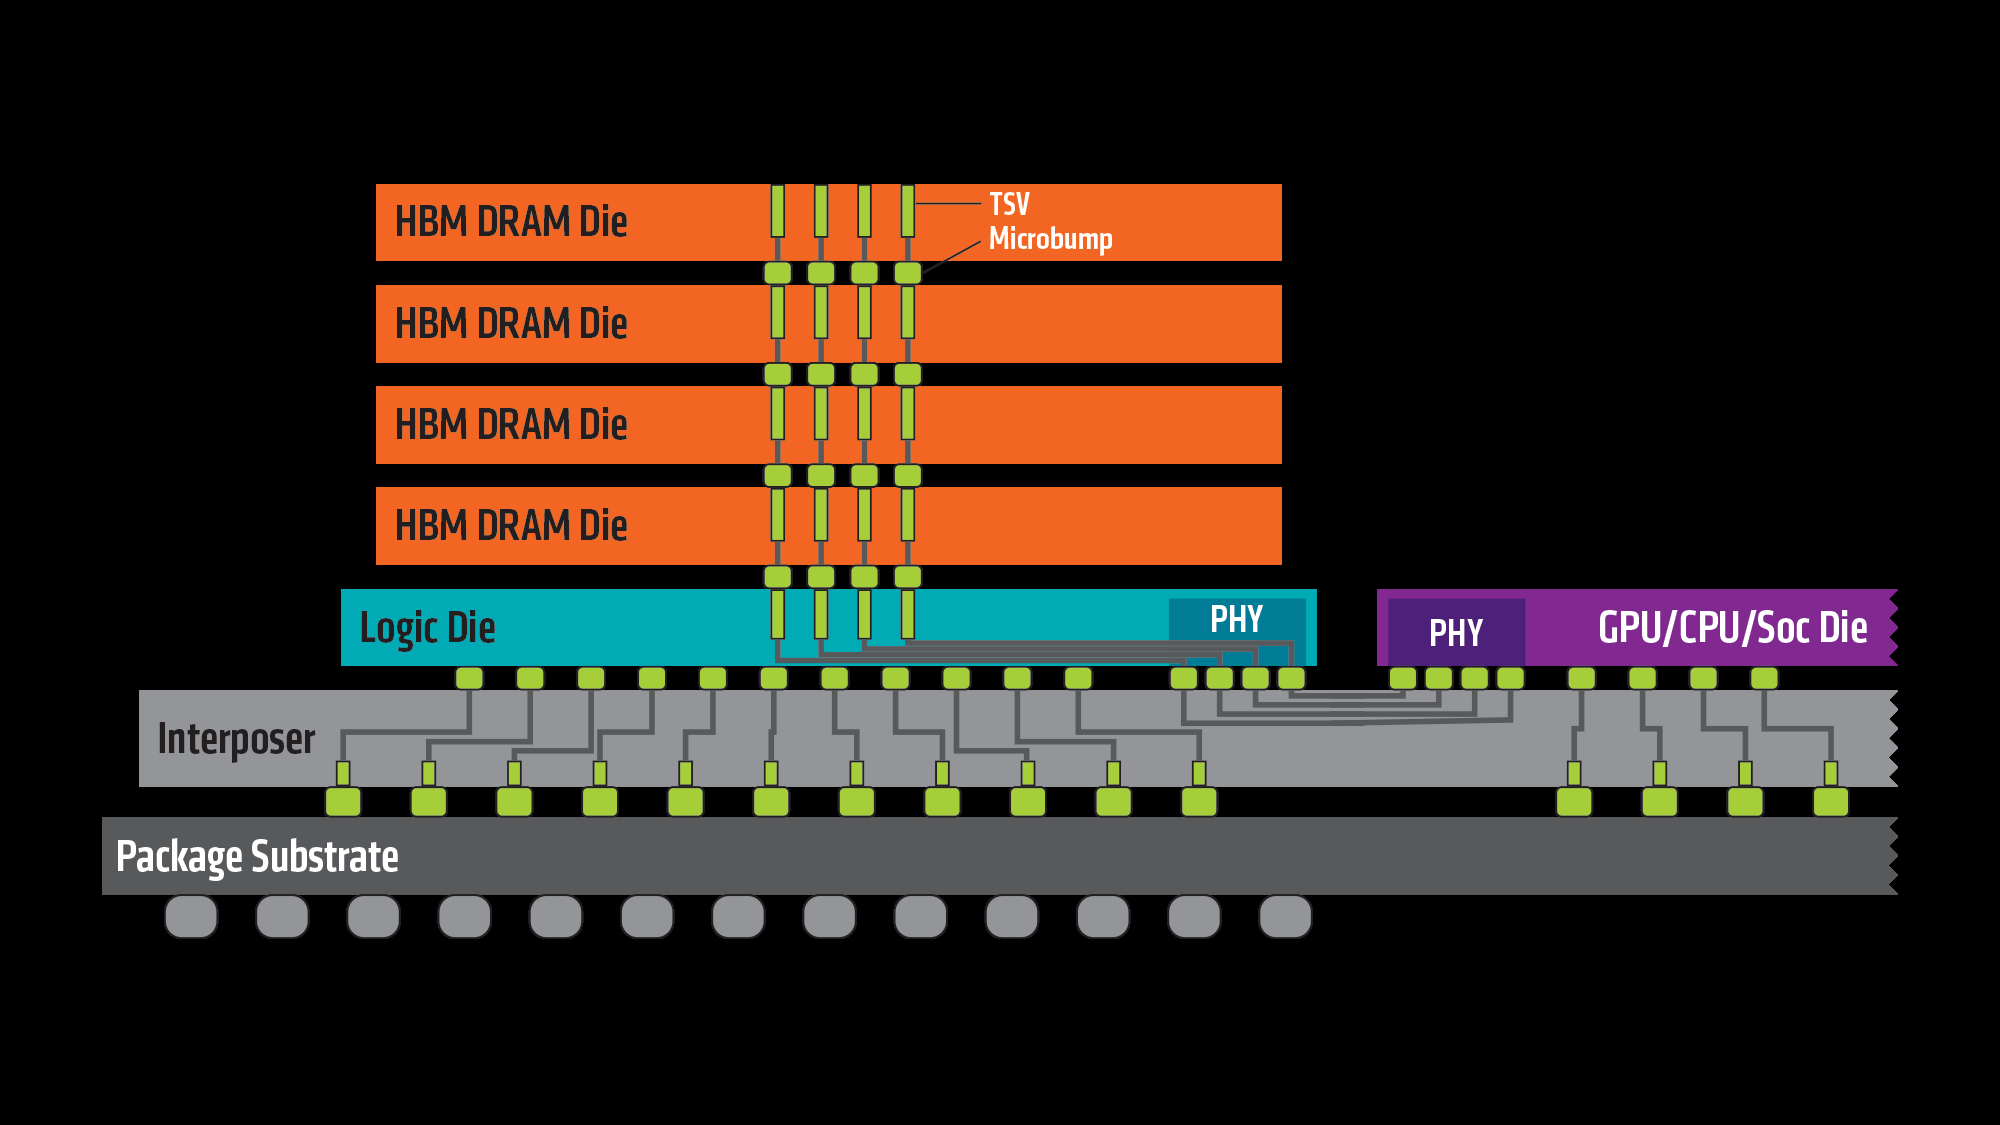
HBM DRAM 透過多通道分散式記憶體介面與主晶片(GPU、CPU 或專用加速器)緊密耦合。每個 HBM 堆疊被劃分為若干個完全獨立的通道,這些通道可以彼此獨立運行,無需同步,從而有助於並行化讀寫操作。
在第一代HBM中,典型的四層DRAM堆疊(稱為4-Hi)提供八個記憶體通道,每個通道寬128位元。這使得每個堆疊的總總線寬度為1024位元。這種多通道結構允許記憶體控制器將流量分配到多個平行路徑上,從而減少瓶頸並提高頻寬利用率。
HBM 介面採用約500 MHz的差分時鐘,指令在訊號的上升沿被記錄。每個通道均工作在 DDR(雙倍資料速率)模式下,這意味著它在時脈訊號的上升沿和下降沿都會傳輸資料。在第一版中,每個引腳的典型傳輸速率為每秒 1 吉次傳輸 (1 GT/s),因此一個 1024 位元堆疊可以實現約128 GB/s 的頻寬。
就容量而言,首批 HBM 顯存堆疊每個封裝最高可達 4 GB。透過在同一 GPU 周圍組合多個堆疊,可以建立數千位元的匯流排。例如,一張配備四個 1024 位元 HBM 堆疊的顯示卡擁有4096 位元匯流排,遠超過當時 GDDR5 顯存典型的 512 位元最大容量。
HBM記憶的起源與發展
HBM概念大約在2008年開始成形,AMD是其主要動力。該公司面臨一個明顯的限制:它需要更大的記憶體頻寬來驅動其GPU,但不斷提高封裝內GDDR晶片的頻率和數量會導致功耗、溫度和PCB尺寸都難以承受。
AMD的目標是設計一種能夠降低功耗和空間佔用,同時大幅提升可用頻寬的記憶體。為了實現這一目標,在專案關鍵工程師之一布萊恩布萊克的指導下,該公司致力於研究各種3D DRAM陣列堆疊方法。
從一開始,AMD 就意識到自己無法單打獨鬥,因此它依賴多個產業合作夥伴。其中一個主要合作夥伴是SK 海力士,該公司在 3D 堆疊記憶體方面已經累積了豐富的經驗。此外,一些專注於中介層技術的公司,例如聯電(UMC),以及一些擅長先進封裝製程的公司,例如安靠科技 (Amkor Technology) 和日月光 (ASE),也參與其中;這些公司對於將整個 GPU + HBM 組件安裝在同一基板上至關重要。
2013年,SK海力士成功製造出首款功能性HBM記憶體晶片。同年10月,JEDEC組織採納了HBM作為正式標準,該標準源自於AMD和SK海力士於2010年共同提交的提案。這些記憶體於2015年開始量產,並於同年應用於商業產品。
首款將 HBM 記憶體引入市場的 GPU 是AMD Fiji系列,於 2015 年 6 月發布。像Radeon R9 Fury這樣的顯示卡證明,雖然製造成本比基於 GDDR 的解決方案高得多,但使用更緊湊的 PCB 也能實現高頻寬,而且不會增加功耗。
HBM記憶體世代的演變
繼第一代HBM問世之後,這項技術不斷發展,衍生出多個容量和性能更高的版本。每一次飛躍都對最初的設計方案進行了改進,在保持3D堆疊和寬總線基本概念的基礎上,將其規模擴展到越來越高的水平。
HBM(第一代)
第一代HBM技術被整合到AMD Fiji GPU中。它提供最多四層DRAM堆疊,每層包含兩個128位元通道,每個堆疊總共八個通道,容量為1024位元。每個堆疊的頻寬約為128 GB/s,典型最大容量為每個堆疊4 GB,而配備四個堆疊的顯示卡總容量可達16 GB 。
相比之下,標準的 GDDR5 記憶體配置每個晶片提供 32 位元數據,最多可並行 16 個晶片,最大匯流排寬度為 512 位元。儘管 GDDR5 的頻率更高,但 HBM 採用八倍於 GDDR5 的總線寬度,彌補了這一不足,在較低頻率下即可實現頻寬的顯著提升。
HBM2
下一個主要迭代版本是HBM2,與第一代HBM相比,其每個引腳的傳輸速度大約翻了一番,達到2 GT/s。在保持每個堆疊1024位元匯流排的情況下,這使得每個封裝的頻寬約為256 GB/s,是第一代產品的兩倍以上。
除了速度提升之外,HBM2 還將每個堆疊的容量提高到8 GB。這使得多堆疊配置成為可能,單一 GPU 或加速器上可以輕鬆添加高達64 GB 的 HBM2 內存,這對於處理超大型模型和資料集的 AI 和 HPC 工作負載至關重要。
2016年1月,三星宣布HBM2早期量產,JEDEC也將其批准為新標準。同年,NVIDIA推出了Tesla P100,這是首款整合HBM2的商用解決方案,旨在用於高效能運算。不久之後,英特爾推出了採用HCDRAM記憶體的Xeon Phi加速器,HCDRAM記憶體是基於與HBM類似的概念,但由美光公司開發。
HBM2E
隨著效能需求的不斷增長,一種名為HBM2E 的更新版本應運而生,它並非全新的標準,而是 HBM2 的升級版。此版本將每個堆疊的有效速度提升至約2,5 Tbit/s,相當於每個堆疊約 307 GB/s的頻寬。
HBM2E的另一個重要改進是能夠堆疊多達12層記憶體(12層堆疊),從而使每個堆疊層的容量高達24GB。得益於這種高密度,配備多個HBM2E堆疊層的GPU或CPU可以提供海量內存,這些內存實際上就集成在處理晶片上。
三星和SK海力士等廠商都開發了各自的HBM2E技術。三星推出了名為Flashbolt HBM2E的產品,每個儲存堆疊包含8顆晶片,容量為16GB,每引腳頻寬高達3,2 GT/s ,這意味著每個儲存堆疊的傳輸速度超過400 GB/s。 SK海力士則發布了16GB容量的儲存堆棧,傳輸速度高達3,6 GT/s,每個儲存堆疊的頻寬約為460 GB/s。
HBM3 與 HBMnext
2020 年末,美光公司以暫定名HBMnext預覽了下一代重大升級產品,該產品後來正式命名為HBM3 。與 HBM2E 相比,這一代產品代表著重大飛躍,旨在滿足資料中心 GPU和大規模 AI 加速器的需求。
HBM3 的設計目標是每個堆疊提供高達665 GB/s 的頻寬,在許多情況下是 HBM2E 的兩倍以上。此外,該標準支援最多16 層(16-Hi)的堆疊,每個堆疊的容量可達 64 GB,這意味著配備多個堆疊的單一 GPU 可以擁有數百 GB 的超高速內存,與晶片本身並存。
為了進一步提高互連效率,一些 HBM3 實現方案採用了 Xperi 開發的DBI Ultra 2.5D/3D 混合互連等技術,優化了不同層和中介層的連接方式,從而降低了電阻,提高了高速訊號品質。
在現今市場上,HBM3顯存已成為GPU領域的熱門選擇,例如NVIDIA H100,它擁有5120位總線和超過2TB/s的總頻寬;又如AMD Instinct MI300X,其總線尺寸更大,達到8192位,顯存頻寬超過5,3TB/s。此外,NVIDIA也在GH200和H200等產品中引進了HBM3E,進一步提升了顯存的有效速度。
具有記憶體處理能力的 HBM(HBM-PIM)
2021年2月,三星採取了不同的舉措,發布了帶有記憶體內處理(PIM)功能的HBM版本。其理念是在每個DRAM儲存體中整合一個專門用於人工智慧任務的小型運算引擎,以便部分處理工作可以直接在資料所在位置完成。
透過這種方法,AI 操作可以在記憶體堆疊內部並行執行,從而最大限度地減少記憶體與 GPU/CPU 之間的資料傳輸。這不僅可以加速某些工作負載,還可以大幅降低與記憶體流量相關的功耗,而記憶體流量是高效能係統中發熱和成本的主要來源。
三星表示,這種 HBM-PIM 記憶體可以將系統效能提高一倍,並將功耗降低 70% 以上,而無需修改平台的其他硬體或軟體,因為外部操作仍然與標準 HBM 介面相容。
HBM記憶體和GDDR記憶體的差別
為了更好地理解HBM的作用,將其與GPU領域的主要替代方案—GDDR顯存進行比較會很有幫助。 GDDR顯存系列(GDDR5、GDDR6、GDDR6X、GDDR7等)是基於與系統DDR相同的概念,但針對顯示卡的高頻寬需求進行最佳化。
GDDR直接焊接在GPU周圍的PCB板上。每個晶片通常具有相對較窄的總線(例如32位元),總頻寬是透過多個晶片並行工作並提高時脈頻率來實現的。例如, GDDR6標準每腳的傳輸速度可達16 Gb/s,而其衍生產品GDDR6X(用於部分NVIDIA GPU)採用PAM4調變方式時,每腳的傳輸速度可達約21 Gb/s。
現代採用 GDDR6 或 GDDR6X 顯存的 GPU 的總匯流排寬度通常在256 到 384 位元左右。這對於絕大多數消費級和專業級應用來說已經足夠,尤其是在時脈頻率可以擴展的情況下。此外,由於 GDDR 顯示卡使用傳統的 PCB,無需中介層或複雜的封裝,因此其製造流程更簡單、成本更低。這使得用戶更容易升級 PC 中的記憶體。
相較之下,HBM 記憶體位於GPU 封裝內部,垂直堆疊在運算晶片旁的矽中介層上。這使得總線容量可達數千位元(5120、8192 等),即使在中等頻率下也能實現極高的頻寬。就每位元傳輸的能源效率而言,HBM 通常明顯優於 GDDR。
然而,HBM 有一個顯著的缺點:其記憶體總量擴展性較差。由於 HBM 記憶體堆疊整合在 GPU 封裝內部,因此無法像 GDDR 那樣簡單地在 PCB 上「添加更多晶片」。這使得記憶體配置的靈活性降低,而每個 HBM GPU 設計都需要從一開始就進行高度客製化的工程設計。
使用HBM記憶體的實際優缺點
HBM 記憶體為某些應用提供了許多非常明顯的優勢,但也存在一些缺點,這解釋了為什麼它沒有在遊戲市場大規模普及。
消除頻寬瓶頸
由於HBM記憶體堆疊與GPU或CPU封裝在同一晶片內,它們透過矽中介層支撐的極短、極寬的訊號路徑連接。這降低了延遲並提高了有效頻寬,避免了記憶體物理位置遠離PCB板時出現的瓶頸。
對於處理大量資料的工作負載(例如具有數十億個參數的 AI 模型、複雜的科學模擬或即時分析),擁有如此龐大的記憶體匯流排對於 GPU 至關重要,它可以決定 GPU 是整天等待資料還是能夠使其運算單元幾乎持續處於忙碌狀態。
更高的能源效率
HBM 的設計理念是將超寬匯流排與適中頻率結合,其直接結果是:每個位元傳輸的能源效率更高。由於 HBM 只需更低的電壓和頻率即可達到與 GDDR 相同甚至更高的頻寬,因此整體記憶體功耗顯著降低。對於家用電腦而言,在記憶體有限的情況下,提升電腦速度通常是一個切實可行的方案。
此外,由於達到相同效能等級所需的記憶體晶片數量較少,因此節省了空間,並減少了更長、更複雜的訊號路徑中產生的電力損耗。這在資料中心環境中尤其重要,因為每一瓦的額外功耗都會轉化為持續的能源和冷卻成本。
更緊湊的外形尺寸
HBM的另一個非常重要的優點是大幅減少了記憶體佔用的實體空間。透過將陣列垂直堆疊並放置在GPU旁邊的中介層上,整個記憶體子系統與在處理器周圍放置十幾個或更多GDDR晶片相比,佔用的空間非常小。
實際上,對於相同容量的顯示卡,HBM 的佔地面積比同等配置的 GDDR5/GDDR6 少 90%。這使得 PCB 設計可以更小,從而為其他元件騰出更多空間,或簡化走線佈局和電源設計。
製造成本高
HBM的主要缺點是成本。製造用於TSV 3D堆疊的DRAM晶圓、組裝堆疊層、生產矽中介層,並將所有組件與GPU封裝在一起,這些製造工藝比將GDDR晶片焊接在PCB上要複雜得多,成本也高得多。
據估計,用於 HBM 的晶圓成本比傳統 DRAM 晶圓高出 30% 到 50%。這還不包括中介層本身的成本和額外的組裝步驟。因此,採用 HBM 的 GPU 通常定位在價格極高的領域,專供資料中心、高階工作站或超級電腦使用。
一個明顯的例子是AMD Radeon Vega系列顯示卡,它使用了HBM2記憶體。雖然顯存頻寬非常出色,但增加的成本影響了顯示卡的最終價格,使其難以與基於GDDR顯示的遊戲顯示卡競爭,後者為家庭用戶提供了更具吸引力的性價比。
HBM 與 GDDR 的典型應用對比
因此,GDDR 和 HBM 之間的選擇很大程度取決於GPU 的預期工作負載類型。
配備GDDR 顯存的GPU通常價格較實惠,主要針對消費市場及一般專業市場。由於顯存直接安裝在 PCB 板上,因此製造成本較低。對於大多數應用(遊戲、影片編輯、3D 視覺化等),GDDR6 或 GDDR6X 提供的頻寬已經綽綽有餘。
相較之下,配備HBM 顯存的GPU屬於小眾產品,主要針對高效能運算 (HPC)、大規模人工智慧和需要最大頻寬利用率的科學工作負載。在這些應用中,成本並非首要考慮因素,縮短模型訓練時間、加速模擬或為數百萬並髮用戶提供推理服務才是關鍵。
生成式人工智慧模型就是一個典型的例子,例如用於進階聊天機器人和推薦系統的模型。基於數千個配備 HBM 的 GPU 的實現方案,例如 NVIDIA H100 加速器集群,能夠即時處理來自數百萬用戶的請求。如果沒有這種強大的運算能力和超高頻寬記憶體的結合,大規模提供此類服務要不是不可行,就是速度慢得令人難以接受。
在更「傳統」的專業領域,高階 GDDR GPU(例如基於工作站架構的 GPU)仍然是訓練中型模型、渲染、模擬和資料分析的非常可靠的選擇,前提是工作負載可以跨多個顯示卡並行化,並且不需要 HBM 提供的極高頻寬。
總體而言,在頻寬和能源效率至關重要且預算允許的情況下,HBM 記憶體已成為理想的解決方案;而 GDDR 記憶體憑藉其在成本、效能和靈活性方面的平衡,繼續在大眾市場佔據主導地位。種種跡象表明,在短期和中期內,這兩種技術將繼續共存:HBM 記憶體將為超級運算和人工智慧的尖端應用提供動力,而 GDDR 記憶體則覆蓋絕大多數消費級和通用專業 GPU。