- Pinapayagan ng PCA ang pagpapasimple ng mga kumplikadong dataset sa pamamagitan ng pagbabawas ng bilang ng mga baryabol sa pamamagitan ng paglikha ng mga pangunahing bahagi na nagpapanatili ng pinakamataas na variance.
- Ito ay batay sa mga konsepto mula sa linear algebra tulad ng mga vector at eigenvalue upang baguhin ang correlated data sa mga orthogonal dimension.
- Ito ay isang pangunahing kagamitan sa preprocessing ng Machine Learning upang maiwasan ang multicollinearity at labanan ang sumpa ng dimensionality.
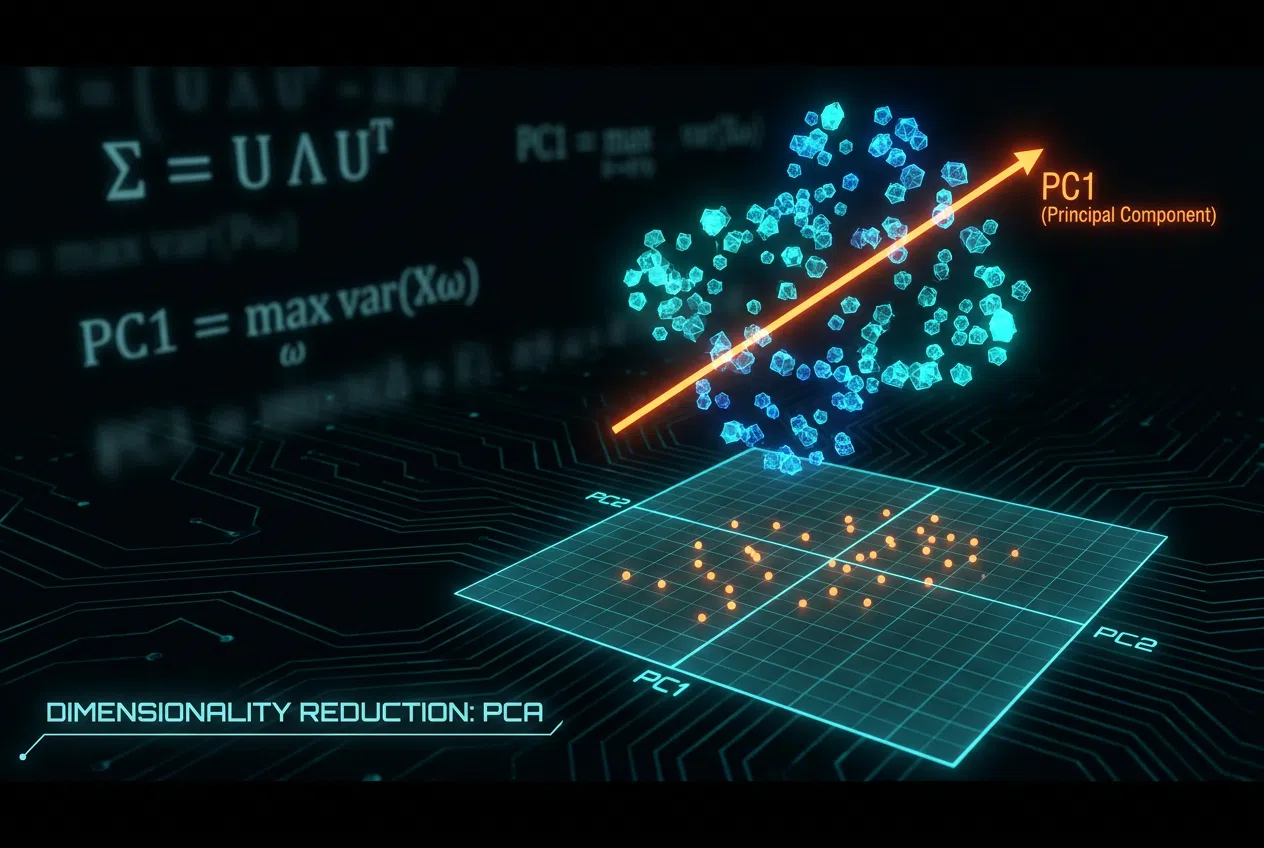
Kapag nahaharap sa mga database na naglalaman ng napakaraming bilang ng mga column, madaling makaramdam ng pagkalito. Ang Principal Component Analysis , na kilala sa buong mundo bilang PCA, ay gumaganap bilang isang matalinong pansala, na tumutulong sa atin na alisin ang ingay at mapanatili lamang ang mahahalagang impormasyon nang hindi nawawala ang pangunahing kahulugan nito. Ang pamamaraang ito, na unang lumitaw noong 1901 salamat kay Karl Pearson, ay nakaranas ng pagtaas ng popularidad sa pagdating ng modernong kapangyarihan sa pag-compute, at naging isang mahalagang tool para sa sinumang nagtatrabaho sa data.
Sa madaling salita, ang ginagawa ng PCA ay kumukuha ng isang hanay ng mga baryabol na karaniwang nauugnay sa isa't isa at binabago ang mga ito sa mga bagong sintetikong baryabol na tinatawag na mga pangunahing bahagi. Ang mahika ay nakasalalay sa katotohanan na ang mga bagong dimensyong ito ay hindi lamang isang seleksyon ng mga luma, kundi mga linear na kumbinasyon na nagtatangkang makuha ang pinakamaraming pagkakaiba-iba hangga't maaari. Ito ay isang walang superbisyong tool sa pagkatuto , na nangangahulugang hindi nito kailangan na sabihin natin dito kung anong resulta ang inaasahan natin; hinahanap nito ang mga nakatagong pattern sa istruktura ng data nang mag-isa.
Ano ang tunay na layunin ng PCA sa mundo?
Sa pang-araw-araw na gawain ng isang Data Scientist, ang yugto ng paghahanda ng datos ang siyang ginugugol ng halos lahat ng oras. Napakahalaga ng PCA para sa preprocessing dahil nakakatulong ito na mabawasan ang pagiging kumplikado ng mga modelo ng machine learning . Kapag nagdagdag tayo ng napakaraming feature sa isang modelo, nanganganib tayong mahulog sa tinatawag na sumpa ng dimensionality , kung saan bumababa ang performance dahil nagiging labis na kumplikado ang modelo.
Bukod pa rito, ang PCA ay ang perpektong lunas laban sa multicollinearity , na nangyayari kapag ang ilang independent variable ay may labis na kaugnayan na nalilito ang modelo tungkol sa tunay na sanhi ng isang epekto. Sa pamamagitan ng pagpo-project ng data sa isang mas maliit at orthogonal na espasyo, inaalis natin ang mga redundancy na ito at naiiwasan ang overfitting , na nagbibigay-daan sa ating mga modelo na mas mahusay na mag-generalize kapag nakatagpo sila ng data na hindi pa nila nakita noon.
Ang makinarya sa matematika: Mga Vector at Eigenvalue
Kung susuriin natin nang mas detalyado, ang PCA ay purong linear algebra. Ang layunin ay hanapin ang mga direksyon sa espasyo ng datos kung saan ang variance ay pinakamataas. Upang makamit ito, gagamit tayo ng covariance o correlation matrix, na kinukuha ang mga eigenvector at eigenvalue.
- Mga Eigenvector: Tinutukoy nila ang direksyon ng mga bagong ehe (ang mga pangunahing bahagi). Perpendikular ang mga ito sa isa't isa, na siyang garantiya na walang ugnayan sa pagitan nila.
- Ang aming sariling mga pinahahalagahan: Sinasabi nila sa atin kung gaano karaming impormasyon (variance) ang naiaambag ng bawat axis. Kung mas mataas ang eigenvalue, mas mahalaga ang component na iyon para sa pagkatawan sa dataset.
Sa pagsasagawa, karaniwan nating nilalayon ang isang balanse. Hindi natin gustong panatilihin ang lahat ng mga bahagi (dahil kung gayon ay wala tayong mababawasan), ngunit ayaw din nating mawala ang masyadong maraming impormasyon. Ang isang karaniwang pamantayan sa industriya ay ang subukang panatilihin ang pagitan ng 80% at 90% ng kabuuang variance , na itinatapon ang natitira bilang hindi nauugnay na ingay.
Mga kritikal na hakbang para sa matagumpay na pagpapatupad
Hindi mo basta-basta maaaring ilunsad ang PCA nang walang taros; kailangan mong ihanda ang pundasyon. Ang unang mahalagang hakbang ay ang central tendency at scaling ng mga baryabol . Dahil ang PCA ay batay sa variance, kung ang isang baryabol ay may mas malaking scale kaysa sa iba (halimbawa, taunang suweldo laban sa edad), ito ay ganap na mangibabaw sa pagsusuri dahil lamang sa laki ng mga numero nito. Samakatuwid, mahalagang i-standardize ang data upang magkaroon ang mga ito ng mean na zero at standard deviation na isa.
Isa pang bagay na dapat bantayang mabuti ay ang mga outlier . Ang PCA ay lubhang sensitibo sa mga ito dahil gumagamit ito ng variance, at ang isang kakaibang data point ay maaaring magpalito ng direksyon ng mga pangunahing bahagi. Upang matukoy ang mga kasong ito sa mga multidimensional na espasyo, kadalasang ginagamit ang Mahalanobis distance , na sinusuri ang distansya sa gitna nang isinasaalang-alang ang ugnayan sa pagitan ng mga dimensyon.
Mga extension at alternatibo: Mula PCR hanggang t-SNE
Hindi nagtatapos sa visualization ang PCA. Nariyan ang Principal Component Regression (PCR) , na gumagamit ng mga nabuong component bilang predictor sa isang linear regression model. Ito ay lubhang kapaki-pakinabang kapag mayroon tayong mas maraming baryabol kaysa sa mga obserbasyon, bagama't dapat tayong maging maingat sa bilang ng mga component na gagamitin, isang bagay na karaniwang ino-optimize sa pamamagitan ng cross-validation upang mabawasan ang mean squared error (MSE).
Kung naghahanap tayo ng mas makapangyarihan na isinasaalang-alang ang response variable, mayroon tayong Partial Least Squares (PLS) , na karaniwang isang pinangangasiwaang bersyon ng PCR. At kung ang PCA ay hindi sapat dahil ang ating data ay hindi sumusunod sa isang linear na relasyon, ang t-SNE (t-distributed Stochastic Neighbor Embedding) ay papasok sa usapin . Hindi tulad ng PCA, ang t-SNE ay nonlinear at isang halimaw para sa 2D o 3D visualization , dahil pinapanatili nito ang mga lokal na distansya at nagagawang paghiwalayin ang mga cluster na maaaring iwanang magkakapatong ng PCA.
Gayunpaman, ang t-SNE ay may mga disbentaha: ito ay isang prosesong hindi deterministiko (maaari kang makakuha ng bahagyang magkakaibang mga resulta sa bawat pagkakataon), ito ay mas mabagal, at hindi ito bumubuo ng mga equation na maaaring bigyang-kahulugan, na gumagana nang mas parang isang black box . Bukod pa rito, ito ay lubos na nakadepende sa isang parameter na tinatawag na perplexity , na tumutukoy kung gaano karaming pinakamalapit na kapitbahay ang isinasaalang-alang kapag lumilikha ng projection.
Binabago ng pamamaraang ito ng pagbabawas ng dimensiyonidad ang pagiging kumplikado ng malalaking dataset tungo sa mga istrukturang mapapamahalaan, na nagpapahintulot sa variance na gabayan ang pagpapasimple ng impormasyon. Sa pamamagitan man ng linear rigidity ng PCA patungo sa mga malinis na modelo ng regresyon o ng kakayahang umangkop ng t-SNE upang matuklasan ang mga visual na pattern, ang pangunahing layunin ay palaging pareho: ang kunin ang kapaki-pakinabang na signal mula sa ingay sa background upang makagawa ng mas matatag at mahusay na mga desisyon na nakabase sa datos.