- AWS-avbruddet oppsto i US-EAST-1-regionen og resulterte i forhøyede feilrater og forsinkelser.
- Årsaken pekte på DNS-problemer som påvirket DynamoDB API-et.
- Det var en global innvirkning på Amazon og tredjepartstjenester; i Spania ble bank og telekommunikasjon påvirket.
- Amazon rapporterte tegn til bedring ved middagstid, med mulige midlertidige begrensninger på grunn av etterslep.
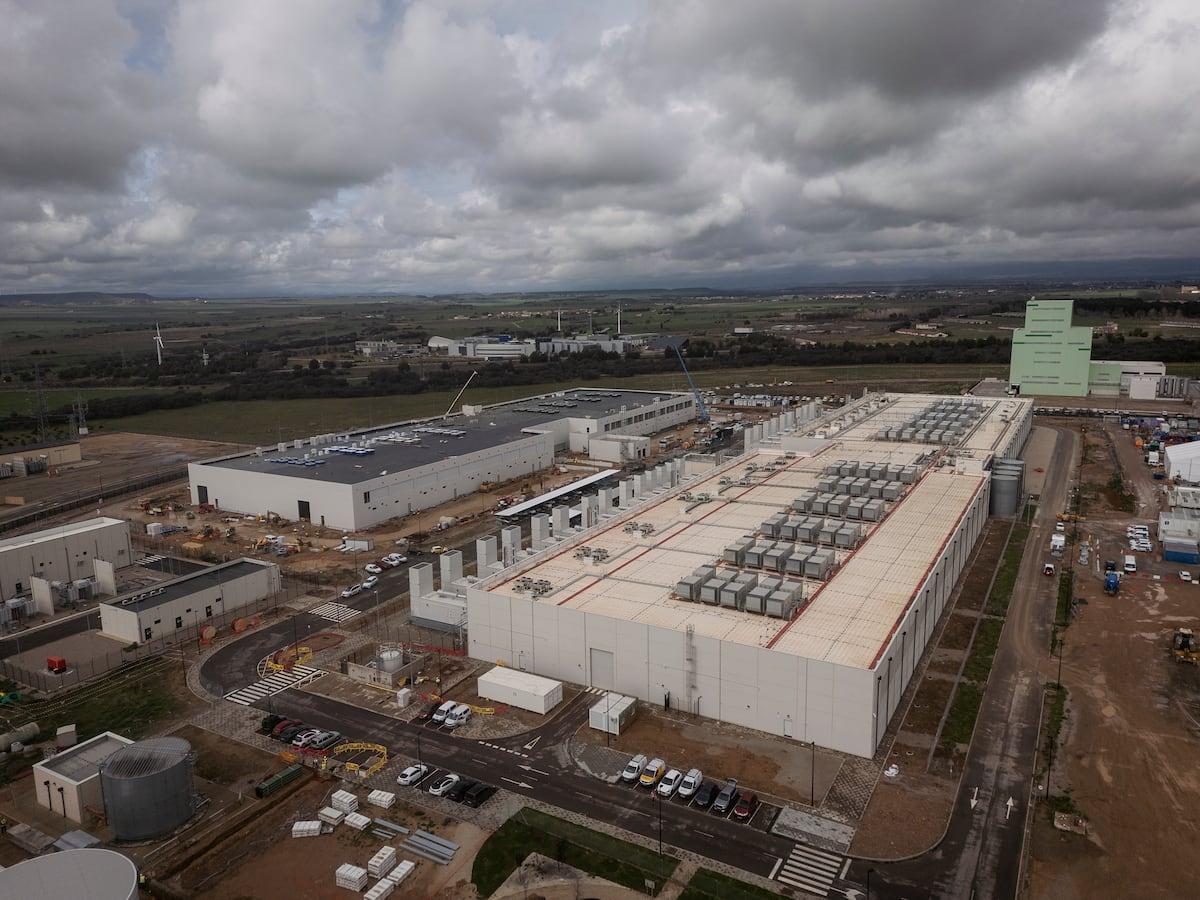
Et omfattende driftsavbrudd hos Amazon Web Services forårsaket omfattende feil på nettsteder, applikasjoner, videospill og bedriftssystemer mandag. Hendelsen ble oppdaget rundt klokken 09.00 (spansk tid) , og selv om situasjonen begynte å stabilisere seg rundt middagstid, har full gjenoppretting skjedd gradvis på tvers av forskjellige plattformer.
Virkningen var omfattende: fra Amazons egne tjenester som Alexa smarthøyttalere og Prime Video til tredjepartsverktøy som Perplexity , Duolingo , Canva og spill som Fortnite , Roblox og Clash Royale . I Spania merket man også forstyrrelser i nettbank (BBVA, ING, Santander og CaixaBank), mobiloperatører som Movistar og Orange , og billettsalg, der Ticketmaster utsatte planlagte utgivelser.
Hva som skjedde og hvor det oppsto
AWS sin offisielle statusside rapporterte en økning i feil og ventetid som påvirket flere tjenester i US-EAST-1 (Nord-Virginia) , en av de mest kritiske regionene. Interne undersøkelser identifiserte raskt et DNS-problem som påvirket Amazon DynamoDB API-oppløsningen , noe som utløste en kaskade av feil.
Ifølge oppdateringer fra selskapet ble det iverksatt tiltak for å redusere problemet, og det begynte å vise seg tydelige tegn på bedring utover morgenen. AWS indikerte at det underliggende DNS-problemet var løst, og at selv om de fleste operasjonene fungerte normalt, kan noen forespørsler være midlertidig begrenset på grunn av etterslep i arbeidet.
Kronologi over forekomsten
De første varslene på overvåkingsportaler som Downdetector ble registrert like før klokken 09.00. Minutter senere bekreftet AWS tjenesteforringelsen på US-EAST-1. Rundt klokken 11.00 annonserte selskapet at de hadde identifisert rotårsaken til problemet som samspillet mellom DNS og DynamoDB API , og begynte å implementere tiltak.
Rundt middag rapporterte AWS betydelig fremgang , og senere på dagen opplyste de at DNS-komponenten var redusert . De indikerte imidlertid at nye forsøk, køer og mindre begrensninger kunne vedvare mens tjenester som CloudTrail , Lambda og lanseringen av nye EC2-instanser ble brakt tilbake på nett.
Berørte tjenester og sektorer
Strømbruddet rammet Amazons egne produkter som Amazon.com , Prime Video og Alexa , i tillegg til populære tredjepartstjenester som Duolingo , Canva , Snapchat og Perplexity , og videospill som Fortnite , Roblox og Clash Royale . Medieutsalg og plattformer med mye trafikk rapporterte til tider om isolerte hendelser.
Finanssektoren ble også rammet, med problemer med overføringer og betalinger via apper og betalingsportaler (for eksempel Venmo i USA) og periodiske strømbrudd som påvirket kryptoplattformer og meglere som Coinbase og Robinhood . De spesifikke problemene varierte etter region og leverandør.
I profesjonelle miljøer indikerte statussider for verktøy som Docker og Atlassian aktive hendelser , mens AWS advarte om høye feilrater ved opprettelse av nye EC2-instanser . Virkningen var ujevn : noen brukere merket ingenting, mens andre opplevde gjentakende avbrudd.
Spania: hva som ble lagt merke til
I landet vårt var det problemer med innlogging eller fullføring av operasjoner i bankapper (BBVA, ING, Santander, CaixaBank), hendelser hos operatører som Movistar og Orange, og problemer med flyplassparkering administrert av Aena på grunn av avbrudd i tjenester som er avhengige av AWS.
Ticketmaster rapporterte problemer med billettsalget og at viktige utgivelser ble forsinket, som for eksempel La Oreja de Van Gogh -turneen , som ble gjort tilgjengelig flere timer senere på grunn av den generelle ustabiliteten i infrastrukturen under hendelsen.
I tillegg ble det rapportert om hendelser ved betalingsterminaler i visse områder, inkludert en midlertidig stans i kortbetalinger på Madrid-t-banen som ble gjenopprettet tidlig på ettermiddagen, hvoretter driften gradvis gikk tilbake til normalen.
I mellomtiden rapporterte Redsys et delvis og midlertidig driftsavbrudd i sin egen kommunikasjonsinfrastruktur. Betalingsplattformen understreket at det var en isolert hendelse som ikke var relatert til AWS- avbruddet , og at systemene ble fullstendig gjenopprettet kort tid etter.
Teknisk årsak: DNS og DynamoDB
Ifølge AWS oppsto forstyrrelsen fra et DNS-problem som påvirket oppløsningen til Amazon DynamoDB API . DNS fungerer som en «katalog» som oversetter tjenestenavn til IP-adresser: hvis den feiler, kan ikke tjenestene finne hverandre, noe som resulterer i feil og tidsavbrudd.
DynamoDB er en NoSQL- database med høy ytelse og lav latens som brukes av utallige applikasjoner med massive trafikktopper. En feil i endepunktløsningen i det berørte området resulterer i mangel på svar eller forespørsler som ikke når frem til destinasjonen , noe som utløser en kjede av hendelser.
I mellomtiden advarte AWS om at noen operasjoner fortsatt var begrenset mens køer ble ryddet og tjenester som CloudTrail og Lambda ble gjenopprettet . Selskapet anbefalte selv at visse kunder prøver forespørsler på nytt , og i spesifikke tilfeller tømmer DNS-cachen sin hvis de fortsatte å oppleve problemer med å løse DynamoDB-endepunkter i US-EAST-1.
Reaksjoner og lærdommer
Sikkerhets- og systemspesialister understreket den gjensidige avhengigheten mellom digital infrastruktur og risikoen ved å konsentrere kritiske arbeidsbelastninger hos få leverandører: en lokal feil kan eskalere til global ustabilitet . Robusthet krever design i flere regioner og realistisk failover-testing.
Det ble også bemerket at de fleste hendelser løses innen timer , men en feilkonfigurasjon eller en mindre menneskelig feil kan ha en omfattende innvirkning . Beste praksis inkluderer å diversifisere skymiljøer eller, som et minimum, distribuere kritiske tjenester på tvers av forskjellige regioner og tilgjengelighetssoner.
Hva du kan gjøre hvis det fortsatt mislykkes
Hvis du fortsetter å oppleve problemer, husk at den underliggende årsaken lå i US-EAST-1 , og at gjenopprettingen har vært gradvis. Det er ofte nok å prøve på nytt senere når køene er tomme.
- Sjekk statuspanel av AWS og den til leverandøren eller applikasjonen din.
- Unngå kritiske endringer (f.eks. lansering nye EC2-er) inntil tjenesten er stabil.
- Hvis du bruker endepunkter for DynamoDB på US-EAST-1 og oppløsningsfeilene vedvarer, prøv tømme DNS-cachen.
- Redskaper eksponentielle nye forsøk og tidtakere i klientene og automatiseringene dine.
Bildet som denne episoden tegner er tydelig: en DNS-hendelse i US-EAST-1 påvirket DynamoDB API og utløste en kjedereaksjon av problemer i dusinvis av tjenester og apper, med global innvirkning og økning i klager i Spania. Etter utbedring gikk de fleste systemene tilbake til normalen med mindre begrensninger, mens køene ble tømt.
