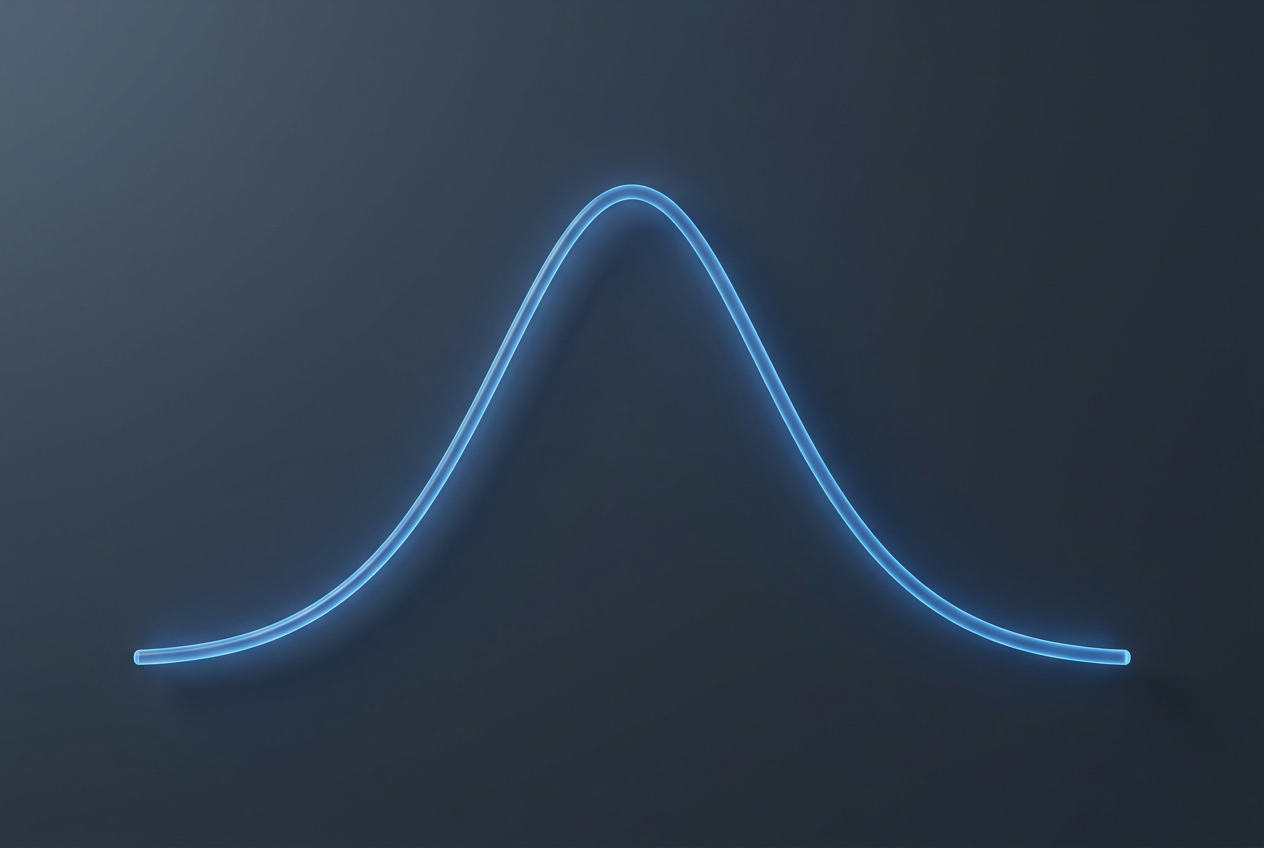
- Het is een symmetrisch statistisch model in de vorm van een klok, waarbij het gemiddelde, de modus en de mediaan in het midden samenvallen.
- Het wordt gedefinieerd door twee belangrijke parameters: het gemiddelde (locatie) en de standaardafwijking (spreiding).
- De empirische regel stelt dat de overgrote meerderheid van de gegevens (99.7%) geconcentreerd is binnen drie standaarddeviaties.
- Het maakt statistische gevolgtrekkingen en de voorspelling van verschijnselen mogelijk in de geneeskunde, marketing, techniek en sociale wetenschappen.
Wanneer we ons verdiepen in de wereld van statistiek en data-analyse, is het onmogelijk om de Gaussische verdeling niet tegen te komen . Je kent hem waarschijnlijk beter als de beroemde normale verdeling; dat instrument dat overal lijkt te zijn, omdat het een verbazingwekkend vermogen heeft om zowel natuurlijke als kunstmatige verschijnselen te modelleren , waardoor we kunnen begrijpen hoe data in de echte wereld georganiseerd is.
In principe hebben we het over een concept dat de spreiding van waarden rond een centraal punt beschrijft. Stel je het voor als een symmetrische klokvormige curve, waarbij het overgrote deel van de informatie in het midden geconcentreerd is en de gegevens naarmate we naar de uitersten bewegen steeds schaarser worden. Het is, simpel gezegd, de basis van moderne statistische inferentie .
Wat is de normale verdeling precies?
Om het concreet te maken: de Gaussische verdeling is een weergave waarbij gegevens zich clusteren rond een gemiddelde waarde. Het meest opvallende visuele kenmerk is de klokvorm , die aangeeft dat de centrale waarden het vaakst voorkomen. Alledaagse voorbeelden hiervan zijn de lengte van mensen , de resultaten van gestandaardiseerde tests of zelfs de meetfouten die we maken in een laboratorium.
Dit model wordt gedefinieerd door twee fundamentele parameters die ons alles vertellen wat we moeten weten: het gemiddelde (µ) , dat het centrum van de klokvormige curve aangeeft, en de standaardafwijking (σ) , die aangeeft hoe breed of vlak de curve is. Als de afwijking klein is, liggen de gegevens zeer dicht bij het centrum; als deze groot is, wordt de klokvormige curve breder omdat er een grotere variabiliteit is.
Wiskundige eigenschappen en de empirische regel
Om het wat technischer uit te leggen: de normale verdeling is symmetrisch, wat betekent dat het gemiddelde, de mediaan en de modus precies op hetzelfde punt samenvallen. Bovendien is de verdeling asymptotisch, wat inhoudt dat de uiteinden van de curve zich tot in het oneindige uitstrekken zonder ooit de horizontale as te raken, waardoor theoretisch elke waarde mogelijk is.
Een fundamentele pijler hier is de 68-95-99.7-regel . Deze regel leert ons dat:
- over 68.3% van de gegevens Ze bevinden zich op één standaarddeviatie van het gemiddelde.
- Dichtbij 95.4% Ze liggen binnen twee standaarddeviaties.
- El 99.7% Alle waarden vallen binnen drie standaarddeviaties.
Vanuit wiskundig oogpunt wordt deze curve gedefinieerd door een complexe kansdichtheidsfunctie die gebruikmaakt van de getallen e en pi. Tegenwoordig is het, dankzij het cybernetische tijdperk, echter niet meer nodig om de formule uit het hoofd te leren, aangezien we beschikken over gespecialiseerde software.
De standaardnormale verdeling en de Z-score
Om te voorkomen dat we gek worden van het berekenen van de oppervlakte onder de curve voor elke afzonderlijke variabele, is de standaardnormale verdeling ontwikkeld . Dit is een speciaal geval waarbij het gemiddelde 0 is en de standaardafwijking 1. Om data uit de praktijk in dit model te passen, gebruiken we de Z-transformatie , die ons in feite vertelt hoeveel standaardafwijkingen een waarde van het gemiddelde afwijkt.
Met behulp van Z-tabellen of tools zoals GeoGebra kunnen we de waarschijnlijkheid berekenen dat een variabele een specifieke waarde aanneemt. Als we bijvoorbeeld weten dat de lengte van mannen een normale verdeling volgt, kunnen we precies berekenen welk percentage van de bevolking langer is dan 180 cm door het gebied onder de curve te analyseren.
Praktische toepasbaarheid in diverse disciplines
Het belang van dit concept is cruciaal, omdat het ons in staat stelt statistische conclusies te trekken . Dankzij de centrale limietstelling weten we dat, als we voldoende grote steekproeven nemen, de verdeling van de gemiddelden van die steekproeven normaal zal zijn, ongeacht de vorm van de oorspronkelijke populatie. Dit is essentieel voor het berekenen van betrouwbaarheidsintervallen en foutmarges.
In specifieke vakgebieden zijn de toepassingen ervan eindeloos:
- Marktonderzoek: Het wordt gebruikt om demografische gegevens te analyseren, consumenten te segmenteren op basis van hun gewoonten en profielen op te bouwen. gedragsmodellen winkelen.
- Geneeskunde en biologie: Het maakt de studie van biologische en psychologische variabelen mogelijk, waarbij onderscheid wordt gemaakt tussen wat pathologisch is en wat als normaal wordt beschouwd. standaard in de bevolking.
- Techniek en kwaliteit: Het is essentieel voor procesbeheersing, het opsporen van afwijkingen en het vaststellen van controlelimieten om de kwaliteit van een product te garanderen.
- Signaalverwerking: Het wordt toegepast in algoritmen zoals de Kalman-filter voor navigatie en tijdreeksvoorspelling.
Hoe kun je zien of je data Gaussisch verdeeld is?
Niet alle datasets volgen dit patroon. Soms hebben we scheve verdelingen (naar links of rechts). Om te controleren of we een normale verdeling hebben, kunnen we software zoals SPSS gebruiken en kijken of het gemiddelde, de mediaan en de modus erg op elkaar lijken. Er bestaan ook strenge statistische tests, zoals de Shapiro-Wilk W-test.
Als de gegevens sterk scheef verdeeld zijn, worden soms logaritmische transformaties toegepast om de verdeling symmetrischer te maken, waardoor parametrische statistische methoden kunnen worden gebruikt. Als dit niet werkt, is de ideale aanpak het gebruik van niet-parametrische toetsen die niet vereisen dat de gegevens een klokvormige curve volgen.
De mogelijkheid om de complexiteit van de natuur te synthetiseren tot een symmetrische curve stelt wetenschappers en analisten in staat om gedrag te voorspellen, hypotheses te valideren en beslissingen te nemen op basis van wiskundige waarschijnlijkheid . Zo wordt de chaos van ruwe data omgezet in gestructureerde en bruikbare informatie voor elke professionele sector.