- La inferència local elimina la dependència del núvol, garantint privadesa total i costos zero per token.
- Eines com Ollama i LM Studio faciliten el desplegament de models quantitzats GGUF en maquinari domèstic.
- La memòria RAM i VRAM són els factors crítics per determinar quina mida de model pot executar cada equip.

Fa tot just un parell d'anys, intentar muntar un model de llenguatge potent a casa era un autèntic malson. Et passaves hores barallant-te amb les versions de PyTorch , instal·lant dependències de CUDA que no encaixaven i gestionant quantitzacions a mà, perquè al final el chatbot fos lentíssim i només servís per fer una demo ràpida. Per sort, aquesta època ja ha passat i avui comptem amb una infraestructura madura on tot flueix molt millor.
Actualment, el panorama ha canviat radicalment. Ja no necessites ser un expert en sistemes per tenir una IA funcionant; hi ha aplicacions que gestionen tot el cicle, des de la descàrrega del model fins a la creació d'un servidor API compatible amb OpenAI, amb només un clic . El catàleg de models oberts ha crescut exponencialment, permetent triar entre opcions com Llama, Gemma, Qwen o Mistral segons el que necessitem en cada moment.

Què implica realment executar una IA local?
Quan parlem de IA local, ens referim que tot el procés —els pesos del model, la inferència i la gestió dels teus prompts— passa dins del teu maquinari . No hi ha dades que viatgin a servidors externs, per la qual cosa les vostres converses i documents mai arriben a mans de gegants com Google o OpenAI. Això és una benedicció per als que manegen dades sota acords de confidencialitat (NDA) , expedients mèdics o codi propietari d'empresa que no poden sortir de la xarxa interna.
A més de la privadesa, hi ha altres punts forts. D'una banda, el compliment del RGPD és immediat , ja que no hi ha transferències internacionals de dades. De l'altra, t'oblides de les factures mensuals per milió de tokens; una vegada que tens el PC, lús és totalment gratuït. També és la solució ideal per treballar en mode offline, ja sigui en un avió o en zones amb una connexió internet que deixa molt a desitjar. Això sí, cal ser realistes: els models tancats d'avantguarda continuen tenint una capacitat de raonament complex superior , per la qual cosa el més intel·ligent és combinar els dos mons segons la tasca.
El maquinari: la clau és a la memòria
Si hi ha alguna cosa que has de gravar a foc és que els LLM són autèntics golafres de memòria. Tot i això, ja no tot depèn de tenir una targeta gràfica caríssima. Gràcies a avenços com truca.cpp , ara podem aprofitar molt millor la CPU i la RAM del sistema.
Ecosistema Apple Silicon
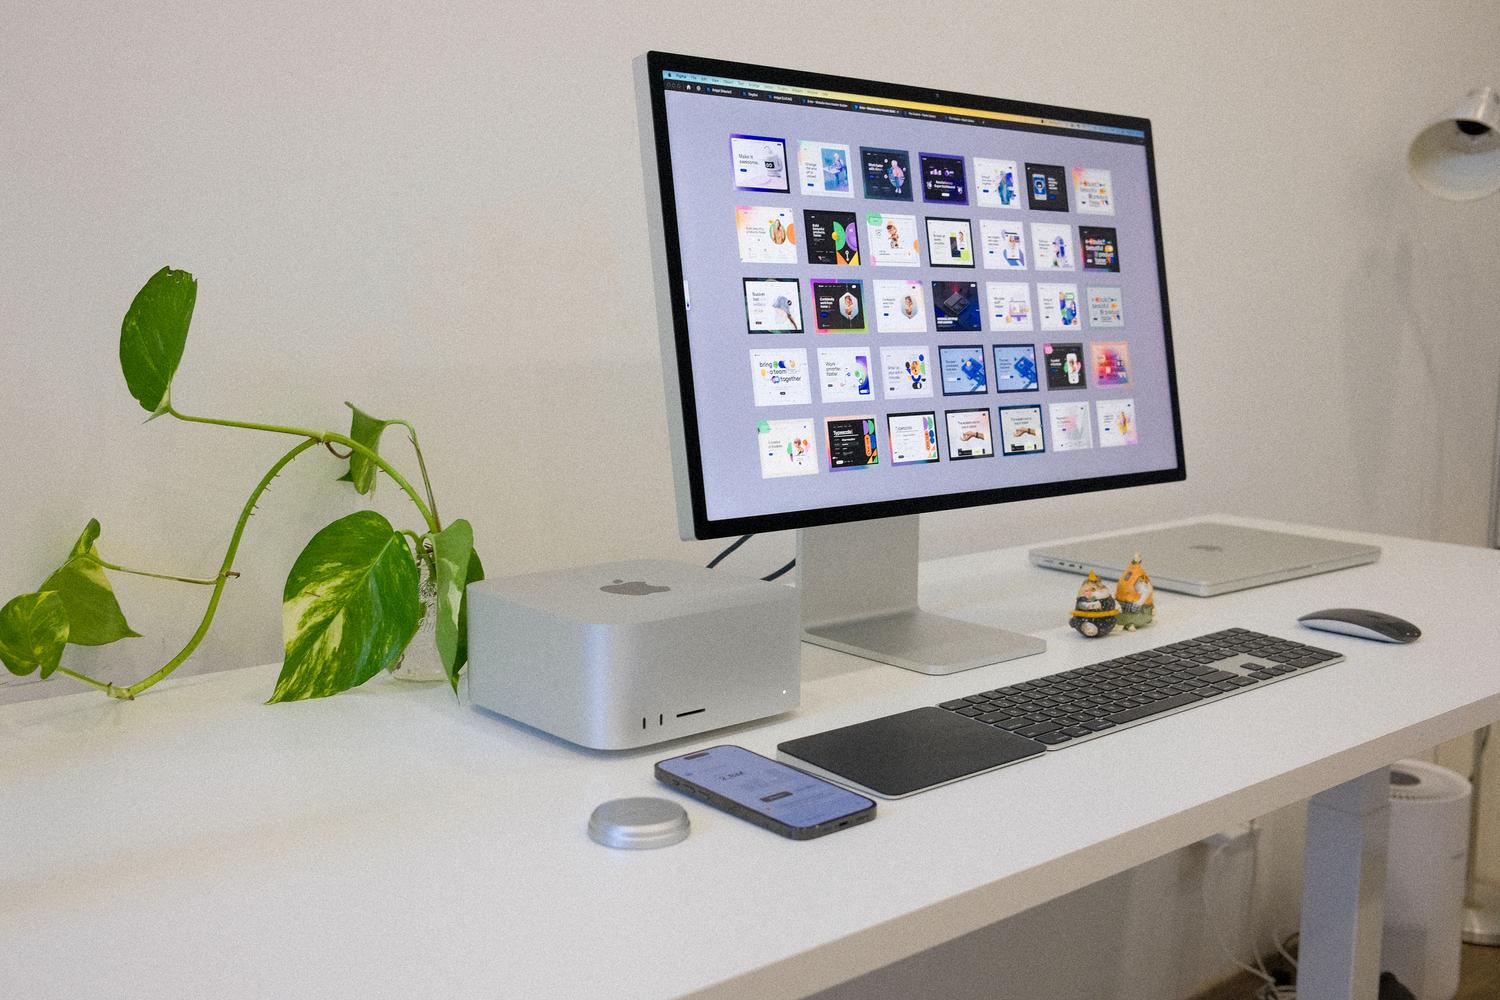
Els Mac amb xips M són, possiblement, l'opció més eficient per a portàtils a causa de la seva arquitectura de memòria unificada . Això permet que la GPU accedeixi a tota la RAM del sistema sense haver de copiar dades, cosa que els dóna un avantatge brutal. Per exemple, un equip amb 16 GB pot moure models de fins a 8B paràmetres còmodament, mentre que els models Max amb 64 GB o més poden executar models de fins a 70B amb quantitzacions agressives, apropant-se a la qualitat de models professionals a casa.
PC amb GPU dedicada
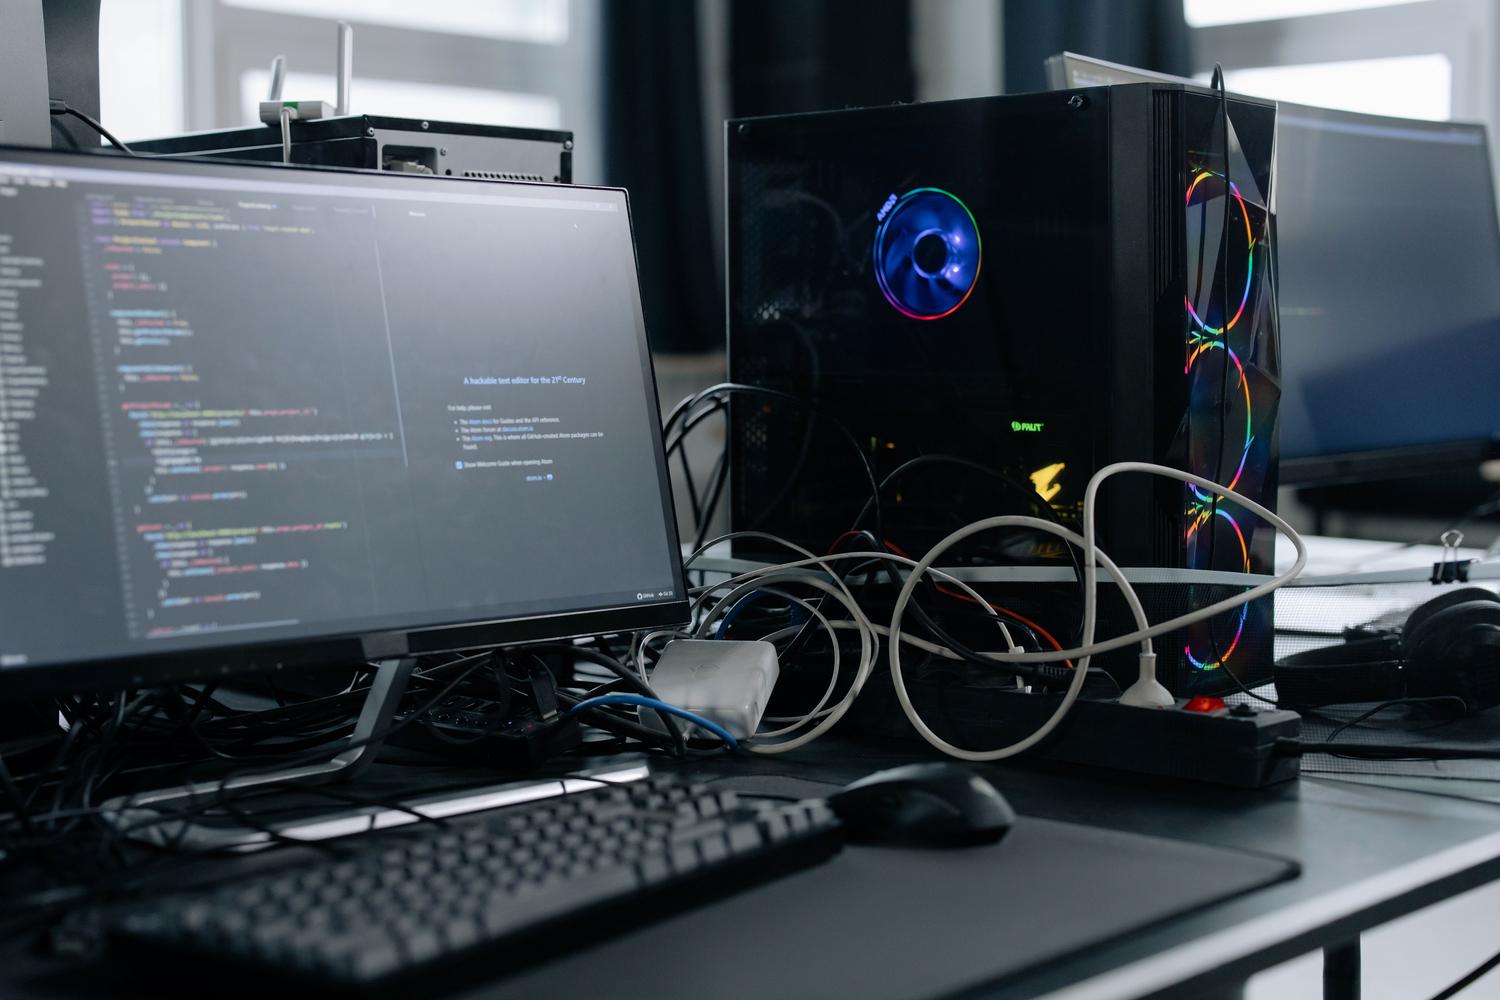
Al món Windows o Linux, el rei és la VRAM de la targeta gràfica. Si tens una RTX 3060 de 12 GB o una 4060 Ti de 16 GB, pots manejar models de 7B a 13B sense problemes. Per als que busquen potència bruta, una RTX 4090 amb 24 GB de VRAM és la joia de la corona, permetent córrer models de 30B sense quantitzar o models de 70B optimitzats. Si muntaràs un equip des de zero, el més equilibrat avui dia és un Mac mini M4 Pro amb 48 GB o un PC amb una RTX 4070 Super.
Eines imprescindibles: CLI, GUI i Runtimes
Per engegar la IA, tenim diverses rutes depenent de quanta fricció vulguem en el procés.
- Ollama: És el motor preferit de molts. És un runtime lleuger que funciona principalment via CLI i ofereix una API REST compatible amb OpenAI. És ideal si busques rapidesa i simplicitat per servir models en segon pla i connectar altres aplicacions a través del port 11434.
- LM Studio: Per als que fugen de la terminal, aquesta és la millor opció. Ofereix una interfície visual impecable, un catàleg on podeu veure els ratings dels models i un servidor local integrat. A Mac, destaca per fer servir el motor MLX d'Apple, aconseguint velocitats superiors a llama.cpp.
- Gener: Una alternativa open-source i auditable que permet alternar entre models locals i APIs al núvol (BYOK), encara que sol ser una mica menys polida que LM Studio.
- llama.cpp: És el motor base a C++ que fa que tot això funcioni. Si ets un usuari avançat i vols esprémer fins al darrer percentatge de rendiment ajustant flags, vés directe a la font.
Entenent els models i el format GGUF
Perquè un model gegant càpiga en un ordinador domèstic, s'utilitza la quantització , que bàsicament comprimeix els pesos del model. El format estàndard per a això és el GGUF , que empaqueta tot el necessari (pesos, tokenitzador i metadades) en un sol fitxer. Una quantització Q4_K_M sol ser el punt dolç, ja que redueix la mida del model en un 70% mantenint una qualitat gairebé idèntica al model original.
A lhora de triar, els models de 7B o 8B paràmetres són lestàndard per a ús general en màquines amb 16 GB de RAM. Si necessites una mica més especialitzat, hi ha variants per a codi o raonament matemàtic. L'ideal és començar amb una quantització Q5 o Q6, i baixar a Q4 només si notes que la memòria queda curta i el sistema comença a anar lent.
Integració al flux de treball i desenvolupament
Tenir el model corrent és només el principi. Perquè sigui útil en el dia a dia, convé utilitzar clients descriptori com Cherry Studio, Msty o Llevant . Aquestes eines permeten gestionar l'historial de xats, fer servir prompts reutilitzables i connectar servidors MCP perquè la IA accedeixi als teus correus, Slack o GitHub. A més, permeten saltar entre un model local i un de núvol a la mateixa conversa, usant el local per a dades sensibles i el de núvol per a tasques de raonament extrem.
Per als desenvolupadors, hi ha llibreries com OllamaSharp o LlamaSharp que permeten integrar aquestes capacitats directament en aplicacions de C#. Pots optar per fer trucades HTTP a un servidor d'Ollama o carregar el model directament a la memòria de la teva aplicació usant el backend de CPU, eliminant qualsevol dependència de serveis externs.
A nivell empresarial, la cosa escala. No pots demanar a cada empleat que gestioni la seva pròpia instància d'Ollama. El més lògic és muntar un servidor d'inferència centralitzat amb maquinari potent (com estacions amb doble A6000) i gestionar l'accés mitjançant una plataforma que controli els logs, els límits d'ús i la seguretat de les dades, mantenint així el control total de la infraestructura.
Tenir una IA local actualment és una decisió intel·ligent per a qualsevol que valori la privadesa o vulgui evitar els costos recurrents de les subscripcions. Des de la senzillesa d'instal·lar Ollama i baixar un model Truca en deu minuts, fins a la complexitat de fer un fine-tuning amb dades pròpies per crear un especialista en un domini concret, les possibilitats són enormes. Encara que els models tancats segueixin liderant la frontera tecnològica, la bretxa es tanca i l'ecosistema d'eines GUI i CLI fa que tenir el cervell de la IA al teu disc dur sigui més accessible i potent que mai.